 Passer au contenu

Je vais vous montrer comment je fais le Décalage Redis je lis et analyse de manière ciblée, et je m'assure de la qualité des donnéesConsistance j'utilise. Cela me permet de détecter rapidement les lacunes de réplication, d'évaluer les risques liés au basculement et de maintenir une synchronisation fiable des clusters en production.
Points centraux
Les points clés suivants constituent une introduction ciblée au sujet, à la terminologie et à la mise en œuvre pratique.
- Décalage mesure la progression du flux de réplication octet par octet.
- Lag correspond à la différence entre master_repl_offset et slave_repl_offset.
- ID + décalage indique une version précise des données pour les synchronisations partielles.
- arriéré protège contre les synchronisations complètes en cas de brèves interruptions de connexion.
- Suivi La fonction INFO/Métrique de cluster gère les alertes et le basculement.
Que signifie le « Redis Replication Offset » ?
Le décalage de réplication est un compteur continu de 64 bits qui, à chaque transfert, flux d'octets entre le serveur principal et la réplique. Cela me permet de savoir où en est la réplication et si une réplique a encore du travail à effectuer. Le master_repl_offset Sur le serveur principal, il augmente à chaque nouvel octet généré, tandis que la réplique incrémente son propre compteur dès qu'elle a appliqué des commandes. Les différences se traduisent par un décalage en octets et indiquent si la réplique est en retard. Cette sémantique simple mais efficace fait de l’offset la valeur centrale pour la synchronisation, l’analyse des pannes et la prise de décisions de basculement sans faille.
Lecture des décalages : bien utiliser la fonction INFO replication
Je commence presque toujours le diagnostic par INFO replication, car cette commande fournit les champs pertinents sous une forme concise. Sur le serveur principal, je vérifie master_repl_offset ainsi que l'état des réplicas connectés, y compris leurs décalages. Sur une réplique, je vérifie en outre `master_link_status` et les états de synchronisation afin de détecter les synchronisations complètes ou partielles en cours. Pour une analyse plus approfondie, j’utilise des sorties structurées et je corrèle les décalages avec les valeurs du CPU, des E/S et du réseau. Ce guide me fournit une introduction approfondie à cette commande : INFO Redis pour la surveillance.
ID de réplication + décalage : version unique des données
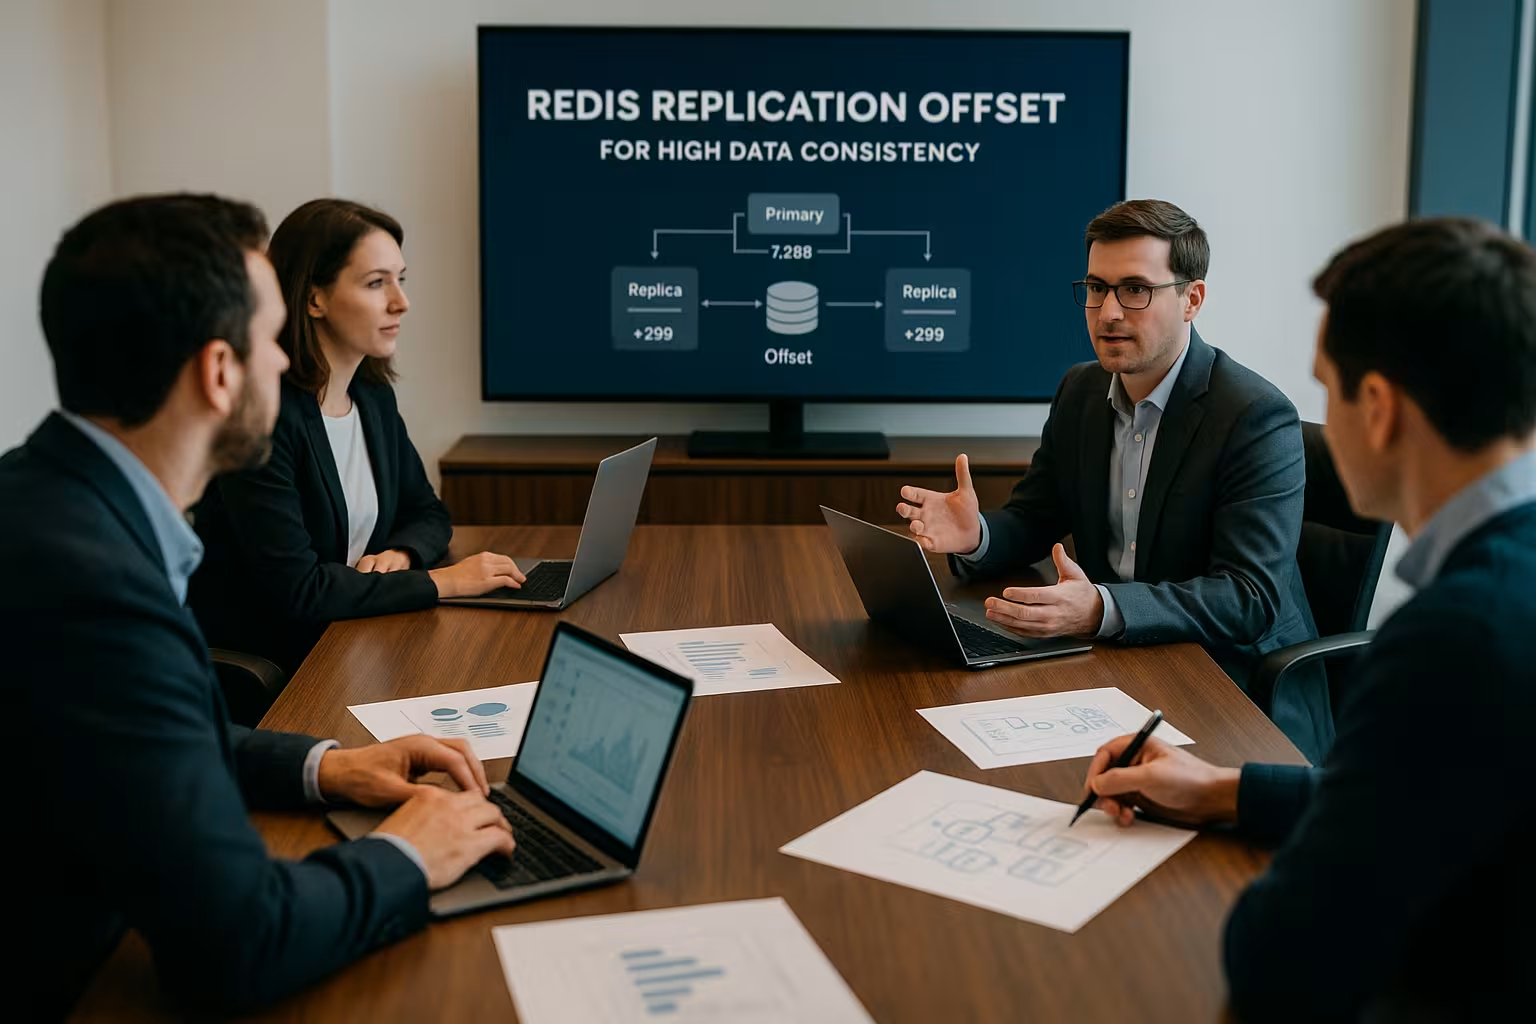
Pour obtenir une version unique, j'utilise la combinaison suivante : Réplication ID et décalage. L'ID identifie un historique, tandis que le décalage indique une position au sein de cet historique. Si l'ID et le décalage correspondent pour deux instances, je pars du principe que les deux possèdent le même état des données. Cette combinaison rend possible la resynchronisation partielle, car une réplique peut indiquer précisément au serveur principal où elle en était la dernière fois. Cela me permet également de déterminer si un basculement peut s'effectuer sans divergence de données ou si une synchronisation complète est nécessaire.
Évaluation du retard de réplication et de l'écart
Le Primary en détient un arriéré sous forme de tampon circulaire, qui stocke les dernières opérations d'écriture et permet des synchronisations partielles. Si la mémoire tampon est trop petite, les octets s’échappent plus rapidement lors des pics de charge et une réplique brièvement déconnectée rate la resynchronisation partielle. Je dimensionne la taille en fonction du profil d’écriture et des objectifs RPO, afin que de brèves interruptions ne déclenchent pas de synchronisations complètes coûteuses. À titre indicatif, je choisis une taille permettant de mettre en mémoire tampon au moins le volume de données attendu pour une durée d’enregistrement de plusieurs secondes à plusieurs minutes. Je réduis ainsi l’écart entre le serveur principal et la réplique et optimise la reconnexion.
Déterminer avec précision le volume du carnet de commandes
Dans la pratique, je ne calcule pas la taille du backlog à l'œil nu, mais en me basant sur le flux d'octets réellement observé :
- J'enquête sur le Débit en octets/s, en mesurant l'augmentation de master_repl_offset à des intervalles définis (par exemple, 10 à 60 s) et en notant les valeurs maximales.
- Je définis une durée d'interruption tolérée (par exemple, fenêtres de maintenance, fluctuations du réseau) en secondes.
- Je multiplie le nombre d'octets par seconde de pointe par la durée de l'interruption et j'ajoute un Facteur de sécurité (1,5 à 3 fois) à cela.
Exemple : 80 Mo/s en pic, 20 s de déconnexion prévue, facteur 2 → 80 × 20 × 2 = 3 200 Mo de retard. Je m'assure ainsi qu'un synchronisation partielle aboutisse, même en cas de timing défavorable. Je vérifie ensuite dans l'outil de surveillance si le backlog atteint rarement sa limite de capacité ; si c'est le cas, je l'augmente progressivement.
Réglage de la fréquence (Hz), de la taille des lots et du réseau
Outre le backlog, je tiens également compte de la hz-Ce paramètre, car il influe sur les cycles de maintenance internes et, par conséquent, sur le décalage moyen. Je vérifie également la taille des lots d'écriture, l'utilisation du pipeline et les paramètres TCP afin de fluidifier le flux de réplication. Une faible latence entre le serveur principal et la réplique contribue directement à réduire les écarts de décalage. Les goulots d’étranglement du côté de la réplique, tels que des supports de stockage lents ou une faible puissance de calcul, augmentent également le décalage. C’est pourquoi je ne modifie qu’un seul facteur à la fois, je mesure l’effet sur l’écart de décalage et je documente clairement ce résultat.
Synchronisation sans disque et effets des instantanés sur le décalage
Pour les synchronisations complètes, je préfère utiliser synchronisation sans disque, car le Primary fournit alors le flux RDB directement via le réseau et ne génère aucune charge d'écriture supplémentaire sur les supports de données locaux. Cela réduit les pics d'E/S et stabilise les décalages pendant les phases de connexion et de déconnexion. Un délai modéré (repl-diskless-sync-delay) laisse le temps à d'autres répliques de se connecter, ce qui permet d'utiliser plusieurs fois un flux RDB. Je surveille à cet effet l'utilisation du processeur et du réseau, car même un transfert sans disque peut entraîner des ralentissements momentanés lorsque les volumes de données sont très importants.
Les instantanés (RDB) provoquent une copie à l'écriture lors d'une bifurcation. Sur les systèmes à forte activité d'écriture, cela augmente temporairement les besoins en mémoire et peut Taux d'application qui ralentissent la réplication. Je programme donc les instantanés à des moments de la journée où l'activité est plus faible, je vérifie les réserves de mémoire et je veille à ce que les chemins de réplication et AOF n'entrent pas en concurrence.
La resynchronisation partielle dans la pratique
Si une réplique est brièvement indisponible, j'essaie toujours d'abord de Comparaison partielle . Lors de la reconnexion, la réplique communique son ID de réplication et son dernier décalage, après quoi le serveur principal fournit les octets manquants à partir du backlog. Si le backlog est insuffisant ou si l'ID a changé, une synchronisation complète démarre avec un transfert RDB et une phase de rattrapage. J’observe à ce moment-là les décalages pour voir à quelle vitesse la réplique rattrape son retard et à partir de quand les deux compteurs se rapprochent à nouveau. Si la synchronisation partielle réussit, les latences et les pics d’E/S restent nettement plus faibles.
ID de réplication, PSYNC2 et comportement en cas de réinitialisation
Pour des interprétations précises, je m'appuie sur la sémantique PSYNC2. Le Primary gère une ID de réplication ainsi qu'un identifiant d'historique avec le décalage correspondant. Dans le cas de Redémarrages ou changements de direction l'ID primaire change ; l'ancien ID est conservé dans l'historique avec un décalage de fin. Une réplique peut ainsi continuer à rattraper son retard par synchronisation partielle malgré le changement d'ID, tant que la plage requise se trouve dans le backlog. J'évalue dans INFO réplication C'est pourquoi je compare les deux identifiants ainsi que leurs décalages, ce qui me permet de déterminer si un changement d'identifiant vient de se produire ou est sur le point de se produire.
Il est important de noter que le décalage est de manière monotone par historique, mais un changement d'identifiant définit une nouvelle chronologie. Je consigne ce changement au cours de l'exploitation afin que les analyses de tendances puissent situer correctement ce changement. Un décalage de 64 bits n'atteint pratiquement jamais sa limite ; les redémarrages, les basculements de secours ou les reconfigurations du backlog, qui influencent l'historique, sont nettement plus pertinents.
Accusés de réception du client et durée de validité dans le contexte Offset
Afficher les décalages Progrès, mais aucune garantie quant à leur durée de vie. Lorsque j'ai besoin de confirmations concernant des répliques, j'utilise en complément :
- WAIT: Le serveur principal confirme une fois que N répliques ont reçu une commande d’écriture et l’ont enregistrée dans leur tampon d’entrée. Ce processus est plus rapide que la sécurité par synchronisation complète, mais ne garantit pas la persistance des données sur les supports de stockage.
- min-répliques-à-écrire et min-replicas-max-lag: Le serveur principal n'accepte les écritures que si un nombre suffisant de répliques sont connectées et que leur décalage reste inférieur à un certain seuil. Cela réduit les risques de « split-brain ».
J'utilise ces mécanismes en conjonction avec l'offset : l'offset vérifie la réelle Vitesse de rattrapage et tendances à long terme, pendant les répliques WAIT/min par commande Offrir une protection. Pour les RPO stricts, je les combine et j'enregistre les deux vues dans le système de surveillance.
Alertes et indicateurs dans la pile de surveillance
Pour le suivi, je définis des Valeurs seuils sur la base de la différence d'offset en octets. Je relie cet indicateur à des séries chronologiques issues de Prometheus/Grafana et je déclenche des alertes lorsque l'écart dépasse une durée définie. De plus, je consigne les tendances afin d’identifier les pics de charge et de planifier des mesures correctives. Des tableaux de bord visualisent le `master_repl_offset`, les décalages des répliques et le décalage calculé, ce qui accélère considérablement les analyses en production. Je trouve ici des conseils pratiques pour les configurations avec des séries chronologiques : Surveillance de Redis avec Prometheus et Grafana.
Guides d'intervention et procédures d'escalade
Je propose des étapes standardisées afin que les équipes puissent agir de manière ciblée lorsque le décalage augmente :
- avertissement: Latence > X Mo pendant > Y s → Vérifier le débit et la latence de la connexion de réplication, identifier les tâches concurrentes (instantanés, scripts Lua volumineux).
- Major: La charge augmente de manière continue → Il existe une corrélation entre le taux d'utilisation du Backlog, l'utilisation du processeur et des E/S de la réplique, ainsi que les erreurs réseau (retransmissions, paquets perdus) ; réduire la charge d'écriture si nécessaire.
- Critique: Le backlog risque d'être saturé → Alléger la charge de la réplique (par exemple, en redirigeant temporairement la charge de lecture), planifier une fenêtre de synchronisation complète ou mettre en service des répliques supplémentaires.
Je documente des arbres de décision afin de déterminer clairement à quel moment un basculement présente encore peu de risques et à quel moment je devrais attendre que l'écart de décalage se résorbe.
Redis Cluster : évaluer les décalages par shard
Dans un cluster, je vérifie les décalages par shard, car chaque shard gère son propre flux de réplication. La commande CLUSTER SHARDS me fournit les plages de slots, les rôles des nœuds et les décalages correspondants pour les nœuds primaires et réplicas. Des écarts importants au sein d’un shard indiquent des risques liés au basculement ordonné de ce shard. Je compare donc systématiquement les décalages de tous les shards et je donne la priorité aux nœuds présentant un décalage minimal comme candidats pour le rôle de leader. Je maintiens ainsi la cohérence de l’ensemble du système et j’évite les surprises lors du basculement.
Au quotidien dans un cluster : surveiller le resharding et la migration des slots
À l'adresse suivante : Décalages de créneaux la charge d'écriture augmente souvent de manière irrégulière. Je mesure les décalages par shard pendant les phases MIGRATE afin de vérifier si certaines répliques prennent du retard. Les fenêtres de migration prolongées associées à de faibles retards sont particulièrement délicates : dans ce cas, je prévois soit des retards plus importants, soit j’échelonne les migrations afin d’éviter la perte de synchronisations partielles. Avant chaque basculement de shard, je vérifie si le nœud cible a récemment pris en charge la charge d’un slot et si l’offset de sa réplique reste stable.
Cas d'utilisation : interpréter l'offset de manière ciblée
Pour évaluer le décalage de réplication, je compare systématiquement le masterJe compare _repl_offset à chaque décalage de réplique et j'en déduis l'âge des données potentiellement obsolètes. Avant une bascule planifiée, j'évalue le risque de basculement en identifiant la réplique la plus proche et en vérifiant sa cohérence sur plusieurs minutes. Si le décalage augmente de manière répétée, je le mets en corrélation avec les métriques réseau, la charge CPU et les E/S afin d’identifier les goulots d’étranglement et de les résoudre de manière ciblée. Pour les objectifs de durabilité stricts, je vérifie également si les opérations sont confirmées dans l’AOF et comment les offsets s’y rapportent. Ces modèles m’aident à fonder mes décisions sur des chiffres objectifs et à limiter les temps d’indisponibilité.
Réplication en cascade et configurations géographiques
Dans les configurations distribuées, je choisis souvent Chaînes répliques (Replica-of-Replica) afin de soulager le trafic inter-réseaux. Je tiens compte du fait que le décalage s'applique séparément pour chaque arête et WAIT : uniquement les répliques directement connectées compte. Pour la réplication géographique, je fixe des budgets de latence réalistes et je mesure les décalages séparément par région. Un basculement régional planifié n'est justifiable que si la candidate principale suivante présente un écart minimal sur une longue période et si les chemins réseau sont stables. En cas de grandes distances, je réduis les écritures en rafale, j’utilise le pipelining avec modération et j’augmente les files d’attente au niveau des nœuds présentant le RTT le plus élevé.
Exploitation en conditions réelles dans des environnements d'hébergement
Dans un environnement géré, je mise sur une approche claire Tableaux de bord, qui regroupent les décalages, les retards et les états de santé. Pour les équipes qui souhaitent accélérer les diagnostics, il est intéressant de se pencher sur des outils offrant une vue approfondie de Redis et une visualisation claire. Cela me permet de détecter rapidement les décalages et de prendre des mesures correctives avant que les retards ne s'accumulent ou que les synchronisations complètes ne génèrent des pics de charge. De plus, je teste les basculements de secours dans des environnements de préproduction et je mesure la vitesse à laquelle les décalages se rééquilibrent après la commutation. Ce guide m’offre une introduction pratique à l’analyse graphique : Redis Insight pour le diagnostic.
Modèles de dépannage en cas d'augmentation du lag
Lorsque l'écart de décalage augmente, je procède selon des schémas récurrents :
- Le processeur réplique fonctionne à pleine capacité: Les goulots d'étranglement monothread ou les scripts Lua gourmands en ressources ralentissent le traitement ; je vérifie cela en examinant le taux de traitement et j'aplanis les pics.
- Pression de la mémoire ou des E/S: AOF-Rewrite, les snapshots ou des voisins bruyants augmentent la latence ; je déplace les tâches, j'optimise les classes de stockage ou j'active la synchronisation sans disque.
- Le chemin d'accès réseau varie: Retransmissions, paquets perdus ou incompatibilités MTU ; je vérifie les erreurs d'interface, les tailles de tampon et je réduis les pertes de paquets.
- Tampon de sortie de réplique: Si la limite pour les répliques est trop faible, le serveur principal interrompt la connexion ; je définis client-output-buffer-limit pour des répliques adaptées à la charge.
- Surcoût TLS: Sur un processeur peu puissant, le chiffrement peut ralentir le système ; je mesure les coûts liés au chiffrement et j'adapte le nombre de cœurs ou j'allège la charge grâce à l'accélération matérielle.
- Outils de diagnostic ayant des effets secondaires: MONITEUR ou un journalisation trop intensive ralentit le système ; j'utilise ces outils avec parcimonie et de manière temporaire.
Je veille à ce que ces schémas restent présents au sein de l'équipe afin que, face à des signaux d'alerte, nous ne repartions pas systématiquement de zéro, mais que nous testions et rejetions rapidement les hypothèses.
Tableau de référence : les indicateurs clés en un coup d'œil
J'aime bien résumer les informations suivantes au travail, car elles présentent les points les plus importants Chiffres clés et regroupe les actions en un seul endroit.
| Signal | Signification | Source typique | Action/Interprétation |
|---|---|---|---|
| master_repl_offset | Octets générés par le serveur principal dans le flux de réplication | INFO réplication | Référence pour le calcul du décalage, suivre l'évolution |
| slave_repl_offset | Octets déjà appliqués par la réplique | INFO : réplication, section « Réplique » | Soustraire de master_repl_offset, déterminer l'écart |
| ID de réplication | Indicateur de l'historique/de la génération des données | INFO réplication | Combiner avec l'offset, vérifier l'ajustement partiel |
| Volume du carnet de commandes | Tampon circulaire pour les blocs d'octets les plus récents | Configuration, INFO replication | Opter pour une capacité supérieure en cas de volume d'écriture élevé |
| replication-offset (cluster) | Décalages par shard pour le primaire/la réplique | FRAGMENTS DE CLUSTER | Évaluer les candidats au partitionnement en vue de la migration |
Résumé : Maîtriser le décalage, éviter les pannes
Je mets le Décalage que j'utilise comme indicateur clé pour contrôler de manière fiable la cohérence, les synchronisations partielles et le comportement en cas de basculement. Grâce à INFO replication, à une taille de backlog adaptée et à un système d'alertes efficace, je maintiens une forte cohésion entre les nœuds répliqués. Dans les topologies en cluster, j’évalue les décalages pour chaque shard et je donne la priorité aux candidats présentant un décalage minimal. L’optimisation de la fréquence (hz), du réseau et des chemins d’accès à la mémoire réduit encore davantage le décalage et évite les synchronisations complètes coûteuses. Surveiller systématiquement les décalages permet de réduire les temps d'indisponibilité et d'augmenter considérablement la fiabilité de l'ensemble de la pile Redis.


