 Passer au contenu

Pooling Redis En PHP, cela réduit la surcharge liée aux connexions, diminue la latence et évite que Redis ne devienne un goulot d'étranglement en cas de charge élevée. Je vais vous montrer comment je configure les pools de connexions avec phpredis et PHP-FPM afin que les sessions, les caches et les files d'attente réagissent nettement plus rapidement.
Points centraux
Je vais résumer les points essentiels de manière concise et claire afin que tu puisses activer correctement le « pooling » sans détours. mise en commun Cela a un impact sur les coûts de transport, les types d'erreurs et la planification des capacités ; c'est pourquoi une mise en œuvre structurée en vaut la peine. Je me concentre sur phpredis, PHP-FPM et les environnements asynchrones, car c’est là que les effets sont les plus marqués. Des paramètres par défaut bien choisis permettent d’éviter des risques tels que les connexions „ polluées “ et d’obtenir des temps de réponse constamment courts. Au final, tu connaîtras les paramètres à ajuster pour optimiser ton Connexions maîtriser.
- Utiliser pconnect au lieu de « connect » pour les sockets réutilisables
- Limites INI pour la taille du pool, les contrôles d'activité, les modèles
- Vote sur le FPM Comparaison avec le paramètre « maxclients » de Redis
- Timeouts Rester concis et tester les scénarios d'erreur
- État Nettoyer avant de le restituer au parc de véhicules
Cette liste présente les priorités que je me fixe pour obtenir des résultats rapides, sans modifier le code à tout va. Persistante Les connexions ne déploient pleinement leur potentiel que lorsque les limites des serveurs et des processus sont bien adaptées les unes aux autres. Je préviens les erreurs courantes en fixant des limites strictes et en appliquant des règles de nettoyage rigoureuses. Cela permet de maintenir une faible latence et garantit que Redis gère de manière fiable même les pics de charge. En effectuant des mesures ciblées, on identifie rapidement où se trouve encore du potentiel et quelle marge de manœuvre le Infrastructure a.
Comment le pool de connexions permet de réduire la latence et d'économiser des ressources
Chaque nouvelle poignée de main TCP prend du temps et sollicite inutilement le système d'exploitation ; c'est pourquoi je réutilise Connexions De manière cohérente. Grâce aux sockets persistants, j’évite les handshakes TLS répétés, ce qui a un impact significatif lors de nombreuses opérations courtes telles que GET/SET. Les pools empêchent la création de milliers de sockets éphémères qui restent bloqués en état TIME_WAIT. Je maintiens le nombre de sockets simultanés à un niveau faible tout en accélérant le traitement. Cela permet d’augmenter le débit et la réactivité sans avoir à modifier en profondeur la logique du code de l’application.
Le pooling est particulièrement efficace dans les configurations PHP-FPM, car chaque processus de travail dispose de son propre piscine gérées. Cela évite à Redis d'être submergé par un afflux de connexions lors des pics de charge. J'en tire immédiatement profit pour les sessions, les caches et les files d'attente, car ces charges de travail génèrent de nombreuses opérations courtes. Ceux qui souhaitent approfondir le sujet des sessions trouveront des informations dans Sessions Redis en PHP une mise en route adaptée. Je règle les paramètres de manière à ce que les erreurs réseau soient rapidement détectées et que l'application bascule vers des solutions de secours si nécessaire.
Dans la pratique, une grande partie de la latence „ froide “ disparaît, car la connexion est déjà établie et il n'y a pas de surcharge liée au DNS ou au TLS. LivenessLes vérifications garantissent que les sockets défectueux n'apparaissent pas dans la requête suivante. Le taux d'erreur reste ainsi faible et l'interaction avec l'utilisateur semble nettement plus fluide. Je procède par petites étapes logiques : activer pconnect, définir des limites, activer la vérification de disponibilité (Liveness). Ensuite, je vérifie l'évolution des métriques et si la charge Redis, le nombre de processus FPM et le comportement de l'application sont cohérents.
phpredis : connect vs. pconnect – que se passe-t-il réellement ?
Avec phpredis Je fais une distinction claire entre `connect()` et `pconnect()`. `connect()` ouvre une connexion temporaire par requête et la ferme à la fin. `pconnect()` crée des sockets persistants que le worker FPM conserve sur plusieurs requêtes. phpredis affecte les connexions persistantes à un pool en fonction de l’hôte, du port, de l’authentification et, éventuellement, du `persistent_id`. Ainsi, à chaque appel, mon code utilise une connexion déjà existante au lieu de recommencer à zéro à chaque fois.
Le tableau suivant m'aide à évaluer rapidement les différences et à faire le bon choix. Vue d'ensemble Cela me fait gagner du temps lors du débogage et de la planification des limites. Je combine cela avec des mesures pour observer les effets au sein de ma propre pile. C'est surtout avec TLS que pconnect apporte des avantages notables. Plus l'opération est courte, plus les handshakes économisés ont un impact important.
| Aspect | connect() | pconnect() |
|---|---|---|
| Durée de vie | Uniquement la requête actuelle | Jusqu'à la fin du processus FPM-Worker |
| Coût de gestion de la poignée de main | Nouveau par requête | Une seule fois, puis réutilisation |
| mise en commun | Pas de piscine | Pool interne par worker |
| Image d'erreur | Beaucoup de prises courtes | Peu de prises, mais d’une grande longévité |
| Recommandation | Cas particuliers, tests | Fonctionnement quotidien |
Je reste dans l'entreprise de production chez pconnect et j’utilise connect uniquement à des fins de diagnostic ou dans des cas particuliers. Les sockets persistants se comportent de manière plus régulière sur un grand nombre de requêtes. Parallèlement, je veille à ne laisser aucun „ état “ qui pourrait causer des problèmes par la suite. Cela vaut surtout pour les transactions et les options, que je nettoie après chaque utilisation. Ainsi, la requête suivante bénéficie d’une connexion propre et l’application reste prévisible.
Paramètres INI importants pour une mise en pool efficace
Les paramètres INI adaptés déterminent à quel point ton piscine gère les connexions. Je définis redis.pconnect.pooling_enabled sur 1 pour que la mise en pool reste active. Avec redis.pconnect.connection_limit, je limite le nombre de connexions par pool, par exemple à 32. redis.pconnect.echo_check_liveness vérifie les sockets réutilisables et élimine celles qui sont défectueuses. Un pool_pattern cohérent garantit que phpredis regroupe correctement les connexions.
Voici à quoi ressemble une configuration de base compacte : Limite 32, Pooling activé, Liveness activé. Cela réduit sensiblement le nombre de sockets TIME_WAIT. Je surveille les clients et les latences, et j'ajuste progressivement les paramètres. Si des délais d'expiration apparaissent, je peux augmenter les limites ou ajuster le nombre de workers FPM. Je me rapproche ainsi d'un état de fonctionnement stable, même sous charge.
redis.pconnect.pooling_enabled = 1
redis.pconnect.connection_limit = 32
redis.pconnect.echo_check_liveness = 1
Je ne choisis jamais des valeurs „ au hasard “, mais je mesure d'abord les Temps de réponse. J'ajuste ensuite les limites maximales jusqu'à ce que Redis, FPM et l'application fonctionnent parfaitement ensemble. Les grands pools peuvent sembler séduisants, mais ils augmentent le risque de dépasser la limite « maxclients ». Les petits pools bien exploités offrent généralement de meilleures performances. Cela permet d'économiser de la mémoire vive des deux côtés et garantit des temps de réponse réguliers.
Synchroniser correctement PHP-FPM et Redis
Je commence par déterminer combien Travailleur fonctionner selon pm.max_children. Chaque worker peut gérer plusieurs sockets Redis ; je ne multiplie donc pas aveuglément les limites de connexion. Redis dispose lui-même d'une limite maxclients que je ne dépasse pas. Je calcule : nombre de workers FPM × nombre de connexions par pool × nombre d'applications, puis je compare ce résultat à la limite maxclients. En conservant des réserves pour les clients d'administration ou de surveillance, je ne risque pas de dépasser cette limite même en cas de forte charge.
Les délais d'expiration font également partie des réglages avancés. Timeouts Les appels au cache typiques prennent entre 0,5 et 1,5 seconde et permettent de détecter rapidement les dysfonctionnements. Je configure les paramètres `connect_timeout` et `read_timeout` de manière prudente et j'enregistre les erreurs de manière détaillée. Cela me permet de voir si le réseau est saturé ou si Redis est surchargé. Si des réinitialisations ou des délais d'attente se produisent fréquemment, j'ajuste les limites, les délais d'attente et le nombre de workers par petits paliers.
Je distingue clairement les erreurs liées aux applications des erreurs de cache. Fallbacks ne doivent pas bloquer la requête si Redis présente un bref ralentissement. Cela améliore l'expérience utilisateur globale et garantit la réactivité des interfaces. Des journaux de bord bien documentés me permettent de déterminer si je suis confronté à une surcharge ou à des ruptures de connexion. Je peux alors ajuster les workers, la taille des pools ou le serveur Redis lui-même.
Un conseil concret : commencez par fixer une limite de „ × 2 cœurs “ par worker, puis vérifiez la charge réelle. Valeurs mesurées Fiez-vous à votre intuition dans n'importe quel environnement. Suivez de près les indicateurs et augmentez progressivement la charge si des requêtes sont en attente. Vous tirerez ainsi pleinement parti du matériel. Parallèlement, le nombre de sockets ouverts restera gérable.
Je consulte régulièrement les rubriques « INFO clients » et « CLIENT LIST » pour connaître la dernière Dernier à observer. Ces valeurs indiquent si les pools fonctionnent correctement ou si de nombreuses nouvelles connexions sont établies. Si je détecte des pics, je vérifie le DNS, le Keep-Alive et les contrôles de disponibilité. En cas de doute, je réalise des tests sans TLS afin de mesurer l’impact des handshakes. Ensuite, je réactive le TLS avec la reprise de session.
Utilisation sécurisée des connexions persistantes
Les sockets persistants conservent leur État jusqu'à ce que le worker s'arrête, c'est pourquoi je nettoie explicitement. Je clôture les transactions correctement avec EXEC ou DISCARD. Pour chaque requête, je configure systématiquement la base de données requise via SELECT ainsi que toutes les options nécessaires à mon code. Avant le retour, aucun pipeline ni MULTI ne doit rester ouvert. C’est la seule façon de garantir que la connexion du pool reste utilisable.
Les contrôles de validité sont obligatoires avant toute réutilisation. Défauts Je bloque immédiatement les sockets et force une reconnexion. Je fais une distinction claire entre „ serveur hors service “ et „ délai d'attente “, car je réagis différemment selon les cas. En cas de délai d'attente, je passe rapidement à des solutions de secours ; en cas de coupure de connexion, je privilégie les reconnexions. Ainsi, l'application reste prévisible, même lorsque le réseau fait des siennes.
Je note les paramètres définis pour une connexion afin d'éviter toute mauvaise surprise par la suite. Transactions Je note cela tout particulièrement, car c'est là que les erreurs ont tendance à se glisser. Pour les bibliothèques, je choisis des variantes qui transmettent correctement pconnect. Lors des tests, je simule des coupures de réseau, des redémarrages du serveur Redis et des pics de latence. Ce n'est que lorsque l'application gère cela sans problème que je la mets en production.
Les états globaux dans les classes d'aide constituent souvent une source de problèmes. nettoyage après chaque utilisation, cela évite que les indicateurs, les modes en lecture seule ou les délais d’expiration ne „ restent activés “. Je centralise la logique de connexion, par exemple dans une classe de service. Cela réduit le taux d’erreurs dans l’ensemble du code. De plus, cela facilite les tests avec des simulacres ou des backends alternatifs.
Quand on modifie rarement la configuration du pooling, on oublie facilement les répercussions sur les tests, l'interface en ligne de commande (CLI) ou les tâches cron. CLI- Les scripts tirent également parti de pconnect lorsqu'ils s'exécutent fréquemment. Pour les scripts qui s'exécutent en continu, j'adapte les contrôles de disponibilité. Pour les scripts exécutés une seule fois, la commande connect avec des délais d'expiration courts suffit. Des valeurs par défaut uniformes permettent d'éviter les surprises en production.
Pooling dans les piles PHP asynchrones (Swoole et autres)
Dans les environnements asynchrones tels que Swoole Les processus PHP de longue durée fonctionnent avec leurs propres modèles de workers. J'initialise le pool Redis au démarrage du worker ou dès la première demande. Les coroutines empruntent une connexion et la restituent après utilisation. La taille du pool peut augmenter de manière dynamique, mais reste limitée. Cela me permet de répartir efficacement les sockets entre les tâches et les requêtes.
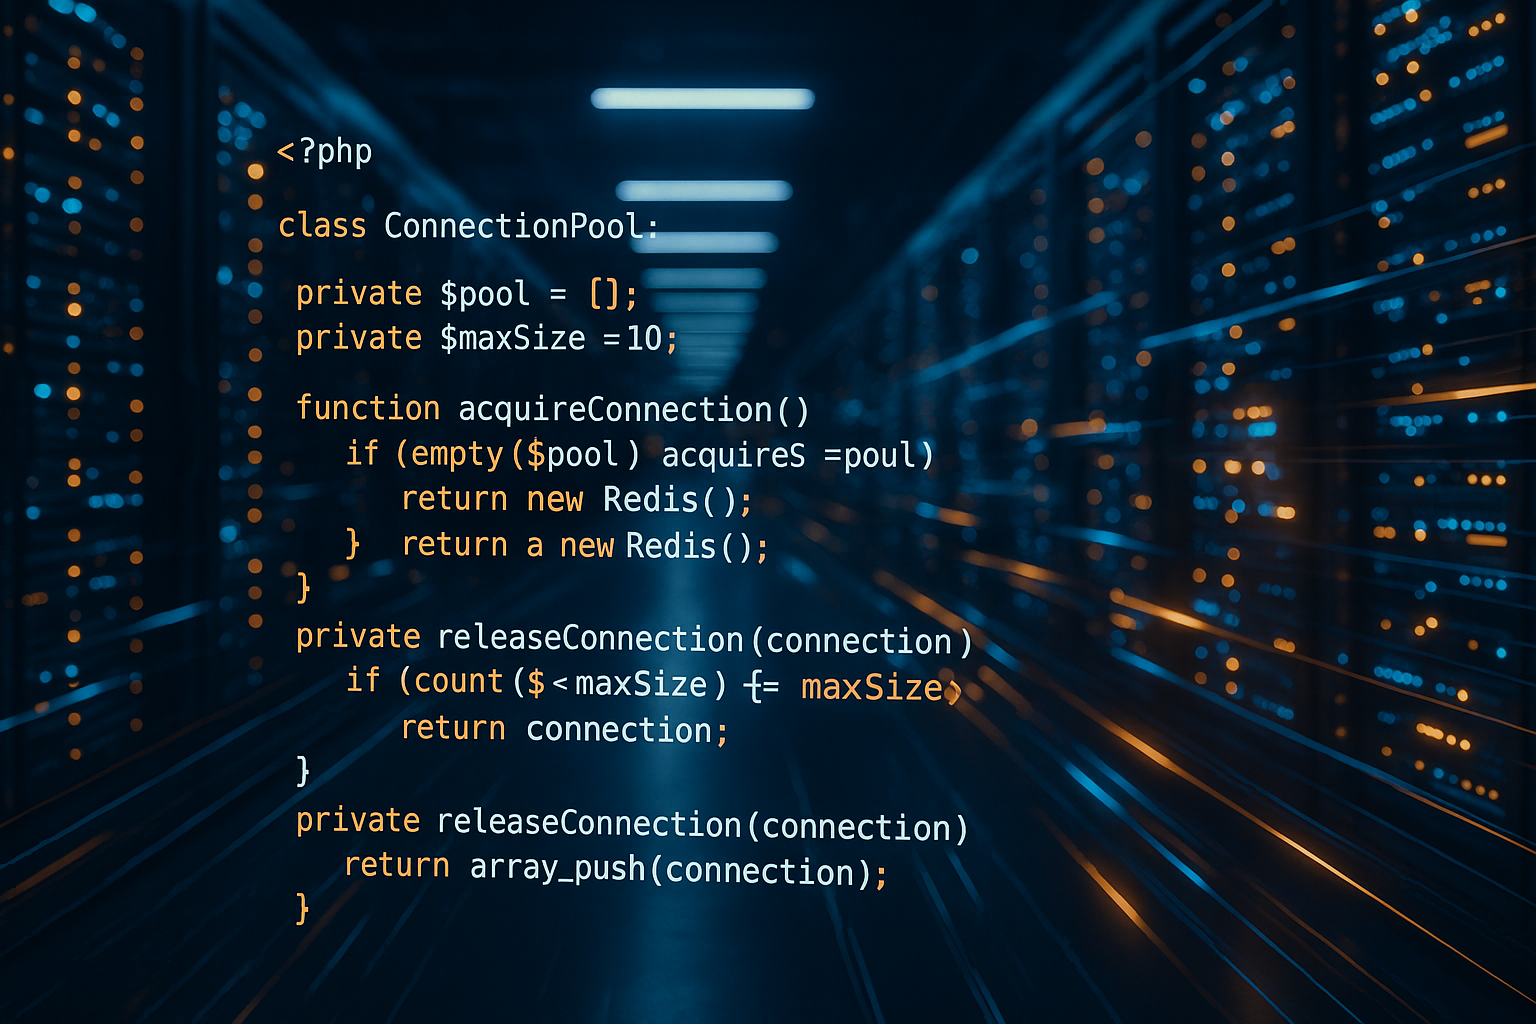
Un objet RedisPool abstrait permet de clarifier le code de l'application. APIs Les méthodes telles que `getConnection()` et `releaseConnection()` encapsulent les détails et empêchent les fuites de mémoire. Je consigne la durée d'emprunt, les taux d'erreur et les temps d'attente dans le pool. Si les temps d'attente augmentent, j'adapte la taille du pool ou le nombre de workers. Cela permet d'éviter la contre-pression et de garantir des temps de réponse courts.
Ici aussi, la règle est la suivante : ne laisser aucun résidu dans les raccords. Transparence Les journaux indiquent si les contrôles de disponibilité fonctionnent correctement. Je teste de manière ciblée les chemins de basculement, y compris les erreurs DNS et la perte de paquets. Cela me permet de détecter rapidement si les stratégies de reconnexion se déclenchent correctement. C'est particulièrement utile lors des tests de charge.
Je tiens particulièrement compte de la surcharge TLS, car les systèmes asynchrones génèrent de nombreuses opérations parallèles. Reprise Le Keep-Alive et le pipelining permettent de réduire le coût par socket. Le pipelining et les lectures par lots contribuent également à réduire le nombre d'allers-retours. L'association avec un sérialiseur allégé permet de gagner encore plus de temps. Au final, ce qui compte, c'est la rapidité avec laquelle l'utilisateur voit s'afficher son résultat.
Pour les métriques, j'utilise des balises par worker et par pool. Traçage Au niveau des requêtes, cela permet de voir quand une tâche attend une connexion. Cela met en évidence les goulots d'étranglement qu'une simple surveillance de Redis ne révèle pas. Je trouve ainsi le juste équilibre entre la taille du pool et le nombre de workers. Les performances se stabilisent ensuite de manière mesurable.
Redis comme couche de mise en cache dans l'hébergement
Dans les environnements d'hébergement, j'utilise Redis pour les sessions, le cache de pages et le cache d'objets, c'est pourquoi mise en commun C'est une obligation. Les accès fréquents et courts tirent largement parti des connexions réutilisées. Pour WordPress, je tiens compte des particularités du cache d'objets et je teste le comportement sous charge. Si vous souhaitez en savoir plus sur les écueils courants, consultez Cache d'objets dans WordPress. C'est ainsi que j'évite les pics de TTFB prolongés et que je garantis un affichage rapide des pages.
Je stocke les sessions dans Redis afin que les workers PHP-FPM puissent fonctionner indépendamment de l'environnement local Stockage à faire. Le pooling me permet de réduire la surcharge liée au verrouillage dans la requête et de préserver les E/S. Il est important de bien séparer les clés de session, les clés d’application et les outils d’administration. Cela me permet de garder une vue d’ensemble lors de la planification des capacités. Pour cela, je documente les TTL afin de laisser les anciennes entrées expirer de manière contrôlée.
Dans les environnements multi-locataires, je segmente les pools par `persistent_id` ou par hôte afin que les locataires fonctionnent de manière clairement séparée. Isolation Cela réduit le risque qu'un client monopolise les connexions des autres. Je veille à ce que les limites par mandant restent réalistes. De plus, je prévois des réserves afin que les tâches d'administration ne soient pas ralenties. Cela garantit une expérience homogène sur toutes les applications.
Pour accélérer les déploiements, je dispose d'une configuration standard que j'ajuste avec précision pour chaque application. Défauts Ils comprennent pconnect, Liveness, des limites modérées et des délais d'expiration clairs. Ensuite, des tests de charge vérifient l'évolutivité. Si un test échoue, j'ajuste les limites et le nombre de workers FPM par petites étapes. Cela me permet d'éviter les réactions excessives et de maintenir une courbe d'apprentissage régulière.
Pour chaque application, je note le nombre de connexions nécessaires en période de pointe. Planification Le fait de se baser sur des chiffres réels permet d'éviter les surprises lors des pics de trafic. Cela permet d'économiser du temps et de réduire les coûts d'exploitation. Parallèlement, le serveur Redis fonctionne sans surmenage. Et les utilisateurs obtiennent des réponses plus rapides.
Gérer correctement le pooling pour Pub/Sub, les commandes bloquantes et les files d'attente
Les commandes Pub/Sub et de blocage telles que BLPOP ou XREAD bloquent le socket. Celles-ci Ski de fond Je ne me connecte jamais au pool général. À la place, j'utilise, pour chaque worker, un client Redis distinct et dédié, exclusivement réservé aux tâches bloquantes ou de type Pub/Sub. Ainsi, le pool habituel reste libre pour les appels GET/SET rapides et la latence des requêtes web reste constamment faible.
Avec les workers BRPOP, je limite le nombre de consommateurs parallèles et je définis des délais d’expiration courts afin que les reconnexions s’effectuent rapidement en cas de dysfonctionnement. Pour Pub/Sub, je sépare strictement les connexions de lecture des connexions d’écriture. Je résilie les abonnements de manière contrôlée avant que le worker ne soit recyclé, afin d'éviter les sockets bloquées. Cette pratique empêche les sockets du pool de rester „ accidentellement “ en mode bloquant.
Transactions, WATCH/UNWATCH et scripts Lua
La mise en commun renforce les effets de états tels que MULTI/EXEC, WATCH ou les caches de script. Après chaque transaction, j'appelle systématiquement EXEC ou DISCARD et j'exécute UNWATCH si j'utilise le verrouillage optimiste. Pour les scripts Lua, Redis met les scripts en cache par connexion ; j'utilise EVALSHA avec un repli vers EVAL en cas d'erreurs NOSCRIPT, afin que le code reste robuste lors des reconnexions et des changements de pool.
function evalsha_safe(Redis $r, string $sha, array $keys = [], array $argv = []) {
  try {
    return $r->evalSha($sha, array_merge($keys, $argv), count($keys));
  } catch (RedisException $e) {
    // NOSCRIPT-Fallback
    if (str_contains($e->getMessage(), 'NOSCRIPT')) {
      // $script hier passend bereitstellen
      return $r->eval($GLOBALS['MY_SCRIPT'], array_merge($keys, $argv), count($keys));
    }
    throw $e;
  }
}
Dans mon bloc `finally`, je désactive également `UNWATCH` si `WATCH` a été activé. Ainsi, la connexion reste „ neutre “ lorsqu’elle retourne dans le pool, et la requête suivante peut s’exécuter sans conditions préalables cachées.
Sockets Unix, TLS et sérialisation/compression
Lorsque PHP et Redis tournent sur le même serveur, je préfère utiliser Sockets Unix. Cela permet d'économiser la surcharge TCP et de réduire encore davantage les latences. L'identifiant « persistent_id » reste identique, seul le point de terminaison change. Sur les systèmes multi-utilisateurs, je veille à ce que les droits d'accès aux sockets soient appropriés.
$r = new Redis();
$r->pconnect('/var/run/redis/redis.sock', 0, 0.5, 'app_pool_unix');
$r->setOption(Redis::OPT_READ_TIMEOUT, 1.0);
Avec TLS, j'active la reprise de session, je réduis la longueur des chaînes de certificats et j'évite les résolutions DNS répétées. Des durées de keep-alive courtes au niveau du système d'exploitation (tcp_keepalive) permettent de détecter plus rapidement les chemins défectueux, sans pour autant effectuer de reconnexions trop agressives.
J'optimise le sérialiseur pour le transfert de données. igbinary Réduit sensiblement la taille des charges utiles et le temps CPU par rapport à la sérialisation PHP. Lorsque cela s'avère pertinent, j'ajoute une compression légère.
$r->setOption(Redis::OPT_SERIALIZER, Redis::SERIALIZER_IGBINARY);
$r->setOption(Redis::OPT_COMPRESSION, Redis::COMPRESSION_LZF);
J'utilise le sérialiseur et la compression de manière sélective : pour les très petites valeurs, cela n'en vaut pas la peine, mais pour les objets volumineux dans le cache d'objets, c'est souvent très avantageux. Des mesures effectuées au sein de ma propre pile permettent d'y voir clair rapidement.
Clusters, Sentinel et basculement avec des pools
À l'adresse suivante : Cluster- Dans mes configurations, j'utilise RedisCluster et j'active les connexions persistantes. Chaque nœud gère ses propres sockets dans le worker. Je surveille les redirections (MOVED/ASK) et je vérifie si leur nombre augmente, ce qui peut indiquer un rééquilibrage ou une répartition inadéquate des clés.
$rc = new RedisCluster('cluster', ['10.0.0.1:6379','10.0.0.2:6379'], 0.5, 1.0, true); // persistent
$rc->setOption(Redis::OPT_READ_TIMEOUT, 1.0);
Avec Sentinel Un niveau supplémentaire surveille le maître. En cas de basculement, je supprime de manière ciblée du pool toutes les connexions vers l'ancien maître et je force une reconfiguration. Je prévois des TTL DNS courts ou j'utilise Sentinel-Discovery directement via une liste d'adresses IP, afin que le changement prenne effet rapidement. Les contrôles de disponibilité détectent de manière fiable les anciens sockets inactifs.
Limites côté serveur, éviction et Keep-Alive
Le pooling ne fonctionne que si Redis est lui-même correctement configuré. Je pense que maxclients avec une mémoire tampon (10–20 %) inférieure à la limite théorique et en tenant compte des clients supplémentaires (administration, surveillance). Je configure la valeur « client-output-buffer-limit » pour les modes normal/pubsub de manière à ce que les consommateurs lents ne saturent pas la mémoire. J'utilise `tcp-keepalive` avec modération afin de détecter les connexions inactives sans générer de charge inutile en paquets.
À pleine charge, c'est la Politique d'expulsion sur le comportement et les latences. Pour les caches, j’utilise des variantes « volatile » ou « allkeys », selon la conception des clés. Important : les évictions apparaissent dans les métriques ; si elles augmentent fortement, c’est que le cache est trop petit ou que la stratégie TTL n’est pas adaptée. J’apporte des corrections avant que les délais d’expiration ne se multiplient.
Calcul de capacité avec un exemple
Un modèle de calcul pratique permet d'éviter les valeurs aberrantes : supposons que 12 workers FPM et trois applications se partagent le même Redis (sessions, cache, file d'attente). Je prévois 2 à 3 sockets par application et par worker (opérations courtes), ce qui donne environ 12 × 3 × 3 = 108 sockets théoriques. Avec connection_limit 16 par pool ; dans la pratique, avec une charge réelle, nous nous situons souvent bien en dessous (60 à 80). Avec un nombre maximal de clients fixé à 1 000, il reste une marge suffisante pour les clients d'administration et de surveillance, ainsi que pour les tâches CLI sporadiques. Je mesure régulièrement les pics et j’abaisse les limites lorsqu’elles ne sont jamais atteintes – cela permet de maintenir la consommation de mémoire par connexion à un niveau bas.
Backoff, Circuit Breaker et Graceful Reload
En cas d'erreurs, je mise sur backoff exponentiel avec du jitter, afin d'éviter les effets de « Thundering Herd ». Après quelques tentatives infructueuses, j'ouvre un disjoncteur et je passe temporairement en mode de secours, plutôt que d'inonder les pools de tentatives inutiles. Les opérations réussies referment rapidement le circuit.
À l'adresse suivante : Reload À partir de PHP-FPM (mode « graceful »), je laisse les workers s'arrêter progressivement. Les connexions persistantes sont ainsi libérées de manière ordonnée. Je surveille si, après un rechargement, il y a brièvement un pic de nouvelles connexions et, si nécessaire, j'ajuste le taux de démarrage des nouveaux workers. Cela me permet d'éviter les pics de connexions lors des déploiements.
Approfondir l'observabilité
Je génère des métriques par worker, par application et par ID de pool. En plus de la surveillance côté Redis, j'analyse les temps d'attente pour obtenir une „ connexion libre “. Si ceux-ci augmentent, cela signifie que le pool est trop petit ou que des opérations bloquantes occupent les sockets. Je crée de simples Runbooks par exemple : „ Si les délais d'attente sont supérieurs à X, alors… “, avec une séquence d'étapes pour la limite du pool, le nombre de workers, le délai d'attente de lecture et l'analyse de la liste des clients. De tels playbooks accélèrent considérablement le dépannage.
Résumé et prochaines étapes
J'active pconnect, je définis une valeur modérée pour `connection_limit`, j'active les contrôles d'activité (Liveness Checks) et j'ajuste le nombre de workers FPM en fonction du paramètre `maxclients` de Redis. Ensuite, je définis des délais d'expiration courts et je nettoie les états de connexion avant de les renvoyer au pool. Grâce à la surveillance et à de petites itérations, je trouve le juste équilibre pour mon application. Les sessions, les caches et les files d’attente réagissent alors plus rapidement et de manière plus constante. Je tire ainsi le meilleur parti du matériel disponible sans trop modifier le code.
Ensuite, je vérifie la Limites mon environnement et mesure les effets du pooling sous charge. Je prévois des réserves pour les clients d'administration et de surveillance. Pour WordPress, j’optimise tout particulièrement le cache d’objets et je vérifie le TTFB. Dans les piles asynchrones, je sécurise l’emprunt et la restitution des pools. Grâce à ces étapes, j’obtiens des temps de réponse courts, de faibles taux d’erreur et des serveurs qui fonctionnent sans surchauffe.


