 Passer au contenu

J'explique de manière concise et approfondie comment Événement MPM qui utilise la file d'attente d'événements Apache pour gérer efficacement un grand nombre de connexions HTTP simultanées. Je présente ici les principes de base, la boucle d'événements, les files d'attente internes et des mesures d'optimisation concrètes pour une performant Configuration.
Points centraux
- Boucle d'événements sépare la gestion des connexions du traitement des requêtes
- Keep-Alive ne bloque plus les fils de discussion
- File d'attente des événements trie les sockets en fonction de leur état
- Paramètres comment ajuster précisément la valeur de MaxRequestWorkers
- Suivi garantit une planification fiable des capacités
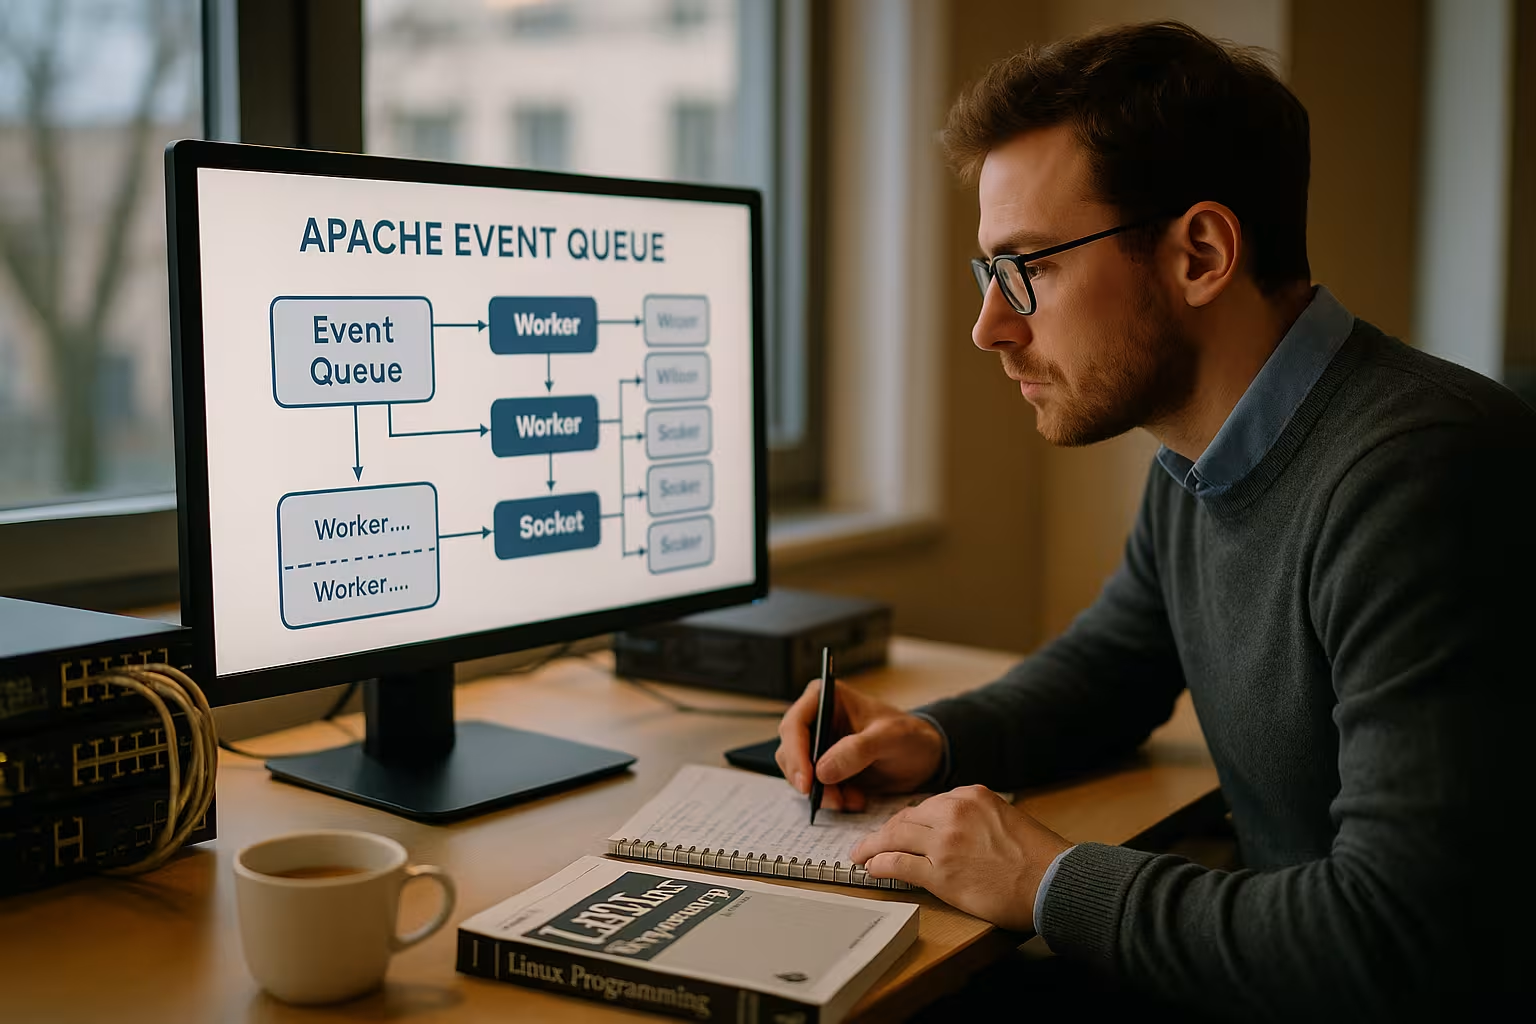
Comment Event MPM gère les connexions
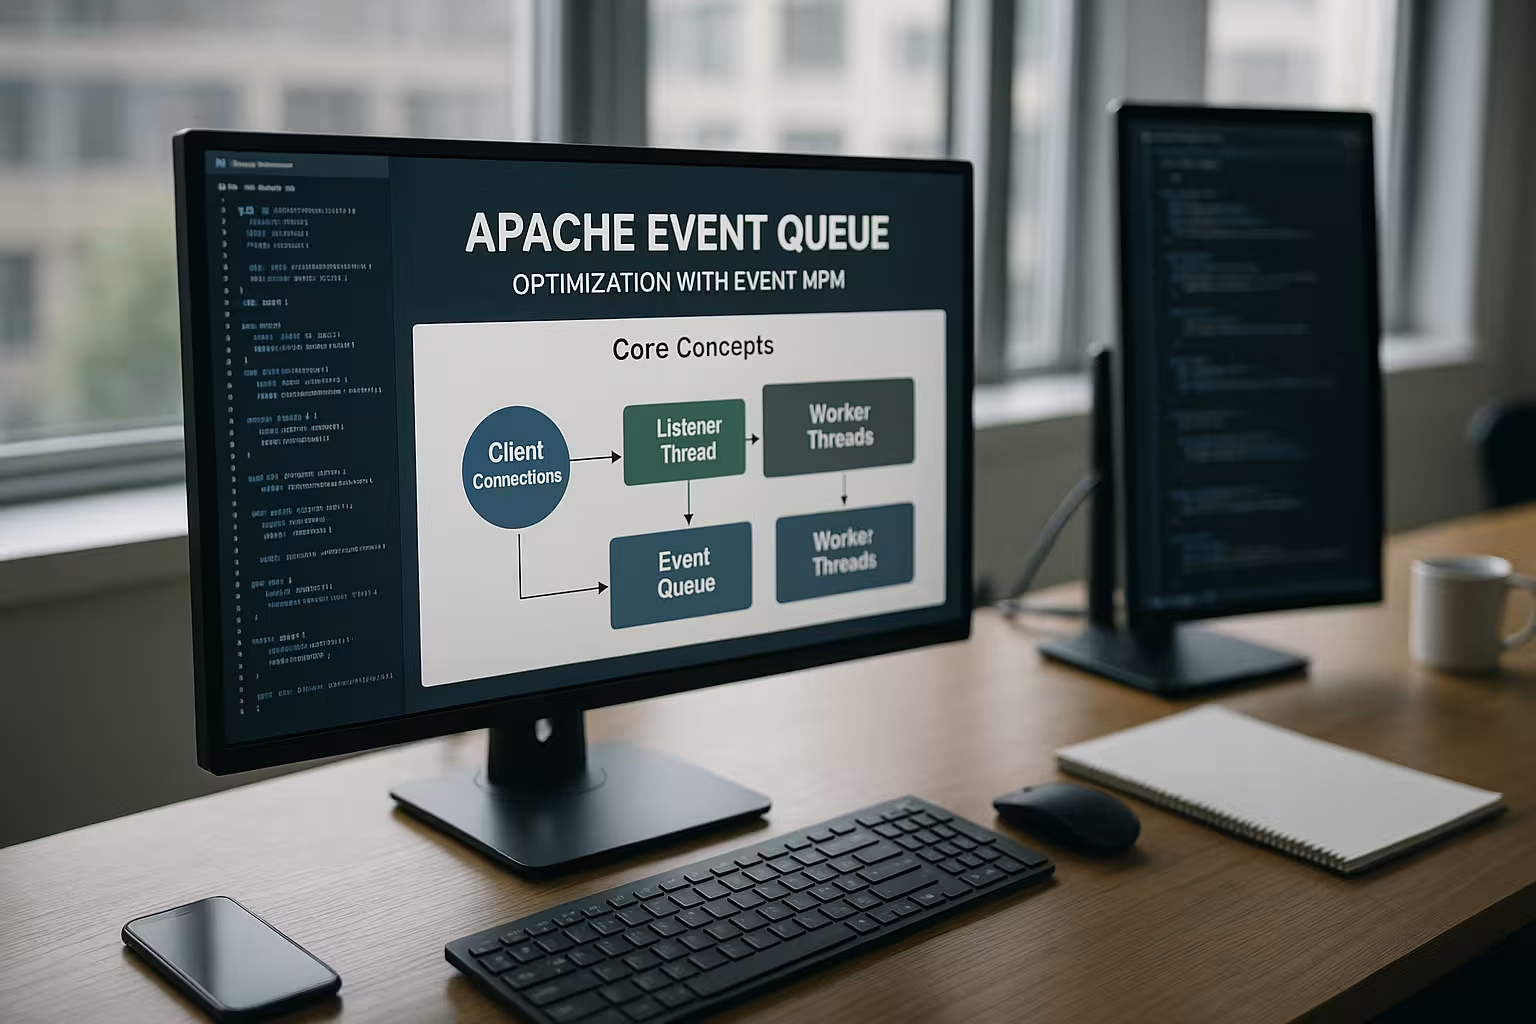
Je vais commencer par me demander comment Apache fonctionne sous Dernier gère autant de connexions. Event MPM combine des processus et des threads, mais donne la priorité aux événements via une boucle d'événements. Les threads d'écoute acceptent les nouveaux sockets et surveillent les connexions existantes sans bloquer immédiatement un thread de travail. Ce n’est que lorsque les données sont prêtes à être lues ou écrites que la couche d’événements transfère le socket à un thread de travail libre. Cela permet d’éviter que ralenti- Les connexions occupent des threads et gaspillent de la mémoire.
Cette séparation réduit sensiblement la charge sur la mémoire vive. Les threads effectuent principalement des „ tâches réelles “ telles que l'analyse des requêtes, la génération de réponses ou la mise en proxy. La boucle d'événements remet ensuite les sockets dans l'état approprié, par exemple en mode Keep-Alive ou en phase de clôture. Dans la pratique, j’observe des files d’attente plus courtes lors des pics de charge, car les threads libres redeviennent disponibles plus rapidement. L’architecture offre une évolutif Performances pour les charges de travail HTTP/1.1 et HTTP/2 typiques.
L'Apache Event Queue en détail
La file d'attente des événements attribue un état à chaque connexion, et c'est précisément là que réside le Bénéfice par rapport aux MPM classiques. Les nouvelles connexions sont d'abord placées dans une file d'attente qui vérifie leur lisibilité. Lorsque des données arrivent, la boucle d'événements déplace le socket vers une file d'attente „ readable “ et l'attribue à un worker. Une fois le traitement terminé, le statut détermine à nouveau la suite : terminer l'écriture, mettre le Keep-Alive en attente ou fermer la connexion. Ce cycle reste léger, car la gestion des files d’attente est assurée de manière économique via epoll ou kqueue.
Je constate souvent des malentendus : la file d'attente d'événements ne remplace pas les workers, elle coordonne leur Utilisation plus efficace. Les threads continuent de traiter les requêtes, mais uniquement lorsque des octets circulent réellement. Cela permet de ménager le processeur et la mémoire dans les scénarios comportant de nombreuses connexions „ inactives “ de type Keep-Alive. Plus la conception des délais d’expiration et des tampons est soignée, plus le risque que les connexions restent inutilement longtemps dans des états coûteux est faible. Cela permet ainsi de maintenir un temps de réponse constant, même avec des milliers de sockets ouverts.
Problème de « keep-alive » des MPM classiques
Avec HTTP/1.1, les connexions restent souvent ouvertes afin de pouvoir envoyer plusieurs requêtes sans nouvelle procédure d'établissement de connexion, ce qui Latence économise. Cependant, les modèles Prefork ou Worker créent pour cela des processus ou des threads qui ne font que attendre. En cas de pics de charge, de nombreuses connexions « keep-alive » bloquent alors de précieuses ressources d'exécution. Cela fait grimper la consommation de RAM et limite le nombre de clients parallèles. Le MPM Event résout ce problème en plaçant les sockets inactives sans thread dans un état d’attente optimisé via la file d’attente d’événements.
Je mets ainsi de nombreuses connexions en attente et ne lance le traitement qu'en cas de besoin réel. Cela modifie le modèle de capacité : au lieu d'avoir « threads = connexions », j'utilise « threads = travail actif ». Dans les scénarios de benchmark, cela me permet d'autoriser un nombre nettement plus élevé de connexions ouvertes sans entraîner de baisses de performance au niveau de la Temps de réaction. Pour les backends API, l'hébergement WordPress et les sites à fort contenu, cela se traduit par une charge de travail nettement plus régulière. Les avantages du « keep-alive » sont préservés, sans que les threads ne se bloquent.
MPM d'événement vs MPM de travailleur
Je résume ces différences de manière concise dans un Tableau ensemble. L'objectif est d'offrir un aperçu rapide de leur fonctionnement, de leurs besoins en ressources et de leurs domaines d'application typiques. Les deux variantes s’appuient sur des processus à plusieurs threads, mais Event lie moins souvent le Keep-Alive à un thread. Worker reste une valeur sûre pour une charge modérée, tandis qu’Event excelle lorsqu’il y a de nombreuses connexions parallèles. Ce classement aide à prendre des décisions cohérentes pour son propre environnement. Je propose une comparaison plus approfondie sous Événement vs. Travailleur.
| MPM | Gestion du Keep-Alive | Threads/processus | Besoin en RAM | Convient pour |
|---|---|---|---|---|
| Prefork | Processus se bloque au ralenti | Uniquement les processus | Haute | PHP hérité sans sécurité des threads |
| Travailleur | fil de discussion reste souvent lié | Processus + threads | Moyens | Charge modérée, configurations simples |
| événement | Boucle d'événements met en attente les sockets inactives | Processus + threads | Faible à moyen | Nombreux clients, longues phases de keep-alive |
Scénarios d'utilisation typiques
J'utilise Event MPM lorsqu'il y a de nombreuses tâches parallèles Clients traiter des charges utiles de petite à moyenne taille. Les blogs à fort trafic, les boutiques en ligne utilisant la mise en cache, les ressources statiques et les points de terminaison API en tirent un avantage notable. Il en va de même pour les configurations d’hébergement comptant de nombreux sites web par serveur, où les connexions « keep-alive » prédominent. La file d'attente d'événements (Event Queue) permet de limiter le nombre de threads actifs et de répartir la charge de travail de manière homogène. Les utilisateurs de HTTP/2 bénéficient d'un avantage supplémentaire, car une seule connexion peut prendre en charge plusieurs flux, tandis que la couche d'événements coordonne les états de manière rigoureuse.
Event démontre également ses atouts dans les topologies de proxy inverse. Je laisse Apache se charger de la terminaison SSL, de la mise en cache et du transfert des requêtes vers une couche applicative. La gestion des connexions reste ainsi légère, ce qui atténue les goulots d'étranglement. Même en cas de pics de trafic, les temps de réponse restent maîtrisables, à condition que les limites soient définies judicieusement. Cela réduit le risque de Queue- Accumulation de messages et délais d'attente.
Configuration : directives de clé
Pour m'assurer que mon hypothèse tient la route, je vérifie d'abord ServerLimit, StartServers, ThreadsPerChild et MaxRequestWorkers. Règle générale : la valeur de ServerLimit × ThreadsPerChild doit être proche de celle de MaxRequestWorkers, en prévoyant une marge pour la maintenance et la croissance. Une valeur trop faible limite le parallélisme, tandis qu’une valeur trop élevée fait exploser les besoins en mémoire vive. Je règle KeepAlive sur « On », mais je définis KeepAliveTimeout de manière modérée afin d’éviter que l’inactivité ne devienne excessive. Des valeurs comprises entre quelques secondes et quelques dizaines de secondes fonctionnent souvent bien, en fonction du profil de trafic.
Je tiens également compte des délais d'expiration pour la lecture, l'écriture et les proxys. Des valeurs plus courtes protègent contre les backends bloqués, tandis que des valeurs plus longues aident à gérer les clients qui réagissent lentement, ce qui Trade-offs est nécessaire. Pour les fichiers statiques, il est préférable de les envoyer par blocs plus volumineux et d'utiliser des chaînes de filtres efficaces. Avec PHP via FPM ou des équilibreurs de charge proxy, j'adapte le nombre de workers backend au niveau de parallélisme du frontend. Je documente chaque modification et j'en mesure l'impact avant de poursuivre.
Optimisation de la file d'attente des événements : étape par étape
Je commence par un clair profil de charge: connexions simultanées, requêtes par seconde, taille des réponses, pourcentage de Keep-Alive. Ensuite, je définis MaxRequestWorkers de manière à ce que le processeur ne reste pas inactif, tout en veillant à ce que la mémoire vive soit largement suffisante. J'ajuste `ThreadsPerChild` jusqu'à ce que les pics de charge soient traités sans temps d'attente. Je calibre `KeepAliveTimeout` pour obtenir un bon équilibre entre l'expérience utilisateur et la préservation des ressources. Si vous souhaitez mieux comprendre le comportement de la mise en file d'attente, vous trouverez des notions de base sous Mise en file d'attente du serveur web.
Je réalise des tests itératifs à l'aide d'outils tels que ab, wrk ou k6 et j'analyse les latences aux niveaux P50, P95 et P99. Ce faisant, j'observe à quel moment les connexions restent actives (Keep-Alive) et à quel moment elles se ferment. Un léger surdimensionnement des threads permet d'absorber les pics de trafic sans surcharger la machine. Parallèlement, je passe en revue les journaux d'erreurs à la recherche de messages tels que „ server reached MaxRequestWorkers “. Cela me permet d'obtenir un cohérent Interaction entre la file d'attente des événements et le pool de travailleurs.
Suivi et métriques
De bons indicateurs garantissent une Capacité. J'active mod_status et je surveille les workers actifs, inactifs et en attente. Le tableau de bord indique si des requêtes sont en attente ou si des ressources sont disponibles. En complément, je mesure le nombre de processus et de threads, l'utilisation de la mémoire vive et les E/S réseau. Une analyse visuelle permet d'identifier les tendances et les points de basculement. Vous trouverez plus de détails dans le Apache Scoreboard.
Je recoupe ces valeurs avec les journaux d'accès et les codes d'erreur. Si les taux d'erreurs 5xx augmentent alors que la charge est maximale, c'est souvent que les limites sont trop basses. Si les délais d'expiration augmentent, je vérifie les services backend, la résolution DNS et les chemins réseau. Je surveille également les files d'attente TCP et les retransmissions SYN en cas de charge élevée. Cela me permet de déterminer si le Cause au niveau du serveur web, du backend ou du réseau.
HTTP/2, proxy inverse et modules
HTTP/2 regroupe plusieurs flux sur une seule connexion, ce qui permet de événement- L'architecture est parfaitement adaptée. Je veille à trouver le bon équilibre entre les limites de flux et le pool de threads, afin d'éviter que de nombreux petits flux ne se retrouvent dans des files d'attente. En tant que proxy inverse, Apache tire parti de délais d’expiration courts et de connexions fiables avec le backend. Cependant, les modules qui fonctionnent de manière fortement bloquante peuvent monopoliser des threads et réduire ces avantages. Je vérifie donc la compatibilité et je remplace les composants obsolètes s’ils génèrent des pics de latence.
Les modules de cache et la compression améliorent l'efficacité, à condition que les profils CPU soient adaptés. L'optimisation TLS avec des algorithmes de chiffrement modernes et la priorisation HTTP/2 contribuent à une diffusion plus rapide. J'utilise la reprise de session et j'observe les coûts liés à la négociation de connexion sous charge. Pour les ressources statiques, les approches « zero-copy » et « sendfile » fonctionnent bien. La Art consiste à alléger la chaîne composée du TLS, de la file d'attente d'événements, du worker et du backend.
Fonctionnement interne et états dans l'événement MPM
Pour comprendre les processus internes, je raisonne en termes de états: accept → readable → processing → writable → keep-alive → close. Les threads d'écoute surveillent les sockets à l'aide de mécanismes efficaces du noyau (epoll/kqueue) et ne réveillent les threads de travail que lorsqu'un événement se produit. Une fois la requête traitée, la couche événementielle décide si la connexion doit être mise en attente en mode „ keep-alive “, fermée immédiatement ou soumise à une procédure de fermeture de type „ lingering close “, afin que les paquets TCP tardifs soient traités correctement. Cet automate à états évite l’« attente active » et minimise les changements de contexte.
Il est important de bien distinguer Temps d'attente d'E/S et la charge du processeur : l'analyse des requêtes, les pipelines de filtrage (par exemple, la compression) et la génération de la réponse s'effectuent dans des threads de travail. L'attente pure et simple de la disponibilité en lecture/écriture reste dans la boucle d'événements. Ainsi, Apache exploite mieux les threads existants et réduit la Densité des fils par connexion ouverte, de manière drastique.
Je tiens également compte du comportement du tableau de bord : dans mod_status, on peut observer des phases telles que „ R “ (Reading), „ W “ (Sending Reply), „ K “ (Keepalive) et „ G “ (Gracefully finishing). Un taux élevé de „ K “ alors que des workers sont disponibles indique que la file d’attente d’événements fonctionne correctement et ne gaspille pas de threads. Si les durées „ R “ augmentent de manière significative, cela peut indiquer que des clients sont lents ou que les délais d’attente de lecture sont trop restrictifs, ce qui laisse entrevoir un potentiel d’optimisation.
Planification des ressources : exemple de calcul et valeurs par défaut pertinentes
Je calcule les Parallélisme composé du processeur, de la mémoire vive et de la charge de travail. Un exemple : 8 vCPU, 16 Go de RAM, contenu principalement mis en cache et PHP-FPM en arrière-plan. Je commence avec MaxRequestWorkers compris entre 512 et 768, ThreadsPerChild entre 32 et 64, et ServerLimit entre 8 et 12 en conséquence. Je prévois 1 à 3 Mo d’overhead Apache plus les modules par worker actif, auxquels s’ajoutent les tampons de réponse, l’overhead TLS et les sockets du backend. De manière réaliste, je réserve 4 à 8 Go pour les processus/threads Apache, 2 à 4 Go pour le cache du système d’exploitation et le reste pour les backends. Je veille à ce que ServerLimit × ThreadsPerChild ne soit jamais inférieure à MaxRequestWorkers ; il est judicieux de conserver une petite marge.
Aperçu des consignes utiles : – MinSpareThreads/MaxSpareThreads: Maintenez la réserve de manière à absorber les pics de charge sans „ démarrage à froid “, mais sans que trop de threads inactifs ne monopolisent la mémoire. – MaxConnectionsPerChild (alias MaxRequestsPerChild) : un cycle de vie fini par processus permet d'éviter la fragmentation de la mémoire et les fuites lors d'un fonctionnement prolongé (par exemple, entre 5 000 et 20 000). – MaxKeepAliveRequests: Limite le nombre de requêtes par connexion ; des valeurs modérées permettent d'éviter les sessions „ infinies “ sans compromettre les avantages du Keep-Alive (par exemple, 100 à 1 000). – Délai d'attente, Délais d'attente en lecture/écriture et ProxyTimeout: Éviter les blocages ; je définis des valeurs différenciées selon le contexte, plutôt que d'adopter une approche trop prudente au niveau global.
Pour les fichiers statiques, j'utilise EnableSendfile et Activer MMAP À noter : sur les disques locaux, ces deux options peuvent présenter des avantages ; sur les volumes NFS/cloud, je désactive souvent sendfile pour éviter les cas limites. Dans les chemins TLS, sendfile a, de par sa conception, moins d'effet, car les données transitent par des pipelines de chiffrement ; ici, ce qui compte avant tout, c'est une chaîne de filtres.
Limites du système d'exploitation et du réseau
Même la meilleure architecture événementielle ne sert pas à grand-chose si les limites du système d'exploitation la freinent. Je vérifie : – Déscripteurs de fichiers (ulimit -n) : cette valeur doit être largement supérieure au nombre maximal de connexions simultanées, auquel s'ajoutent les sockets du backend ; il est courant d'atteindre plusieurs dizaines de milliers pour les serveurs très sollicités. – ListenBacklog: Un backlog d'acceptation suffisamment important permet d'éviter le rejet des paquets SYN lors des pics de trafic. – Retards dans le développement du noyau (par exemple, somaxconn) et les files d'attente SYN : elles doivent correspondre au débit „ en rafale “ prévu. – Mémoire tampon réseau (rmem/wmem) : Ne pas surdimensionner, mais choisir des valeurs permettant d'éviter l'engorgement des liaisons à temps de transit élevé (RTT) ou à bande passante élevée.
Je répartis la charge d'acceptation à l'aide de plusieurs threads d'écoute et je laisse généralement la plateforme choisir le mécanisme d'acceptation (AcceptMutex auto). Sur les systèmes qui le prennent en charge, il est possible de SO_REUSEPORT (en fonction de la plateforme, via une option de liste) lisser les chemins d'acceptation. Il est important d'éviter les situations de « thundering herd », dans lesquelles de nombreux threads se disputent la même acceptation.
Voir aussi Ports TCP éphémères (ip_local_port_range) et le comportement TIME-WAIT doivent être adaptés au nombre de connexions proxy parallèles. J'évite les réglages trop agressifs ; je préfère effectuer des tests réalistes et m'assurer que les backends prennent en charge le Keep-Alive, afin que les connexions puissent être réutilisées et que le nombre de changements de port soit réduit.
Les subtilités du proxy inverse : pools de connexions et backends
En tant que proxy inverse, les performances globales dépendent fortement de la stabilité des connexions backend. Je veille à ce que Connexions par proxy Maintenez la persistance (Keep-Alive vers le backend) et dimensionnez les pools de backend de manière à ce qu’ils suivent le parallélisme du frontend. Des pools trop petits provoquent un engorgement du frontend, tandis que des pools trop grands génèrent une charge inutile sur l’application.
Mesures concrètes : – ProxyTimeout: Plus courts pour les chemins non critiques, plus longs pour les points d'extrémité „ coûteux “ – il faut nuancer, et non appliquer une règle globale. – Équilibreur-Paramètres (pour mod_proxy_balancer) : pondérations, nombre maximal de connexions par serveur backend, intervalles de réessai en fonction de l'état de santé. – mod_proxy_fcgi pour PHP-FPM : le FPM-pm.*Les valeurs (pm.max_children, pm.start_servers, etc.) doivent être adaptées au parallélisme d'Apache afin d'éviter les pics d'erreurs 502/504.
Je veille à ce que les erreurs côté serveur soient signalées de manière claire et rapide, plutôt que de monopoliser les threads côté client. Les contrôles d'intégrité, une politique de réessai prudente et des modèles de type « circuit breaker » permettent de maintenir les latences à un niveau stable. Dans la mesure du possible, je veille à ce que Mise en cache des réponses aux endroits appropriés, afin que l'événement MPM puisse envoyer avant tout des réponses courtes et concises.
Réglage fin de HTTP/2 sous Event
Pour HTTP/2, outre le protocole TLS, j'optimise surtout Limites de flux et l'affectation des workers. Un grand nombre de petits flux par connexion peut réduire la latence, mais augmenter la charge des threads. Je définis le nombre maximal de flux par session de manière à ce que le multiplexage soit efficace, sans pour autant entraîner un effet de „ head-of-line “. De plus, j’augmente le nombre de workers de manière prudente afin d’amortir les pics de trafic sans saturer la mémoire vive.
Je remarque que les flux restent souvent en attente alors que des threads sont disponibles. Dans ce cas, ce sont généralement les limites des flux ou la taille des tampons qui restreignent le débit. Une Définition des priorités L'optimisation des ressources critiques (par exemple, les fichiers CSS/JS via les priorités HTTP/2) a un impact direct sur les performances perçues. Du côté du protocole TLS, la reprise de session, les mécanismes de type 0-RTT (dans la mesure où ils sont sûrs et disponibles) et les algorithmes de chiffrement modernes réduisent les coûts liés à la phase de négociation.
Robustesse : délais d'attente, protection contre les attaques « Slowloris » et arrêt en douceur
J'active mod_reqtimeout, afin de pallier les phénomènes de type « slow loris ». Les délais d'expiration en lecture empêchent les clients de transmettre des octets à une vitesse d'escargot et de monopoliser ainsi les ressources. Les délais d'expiration en écriture protègent contre les connexions lentes vers le client. Ces valeurs doivent être choisies en fonction du contexte : les API nécessitent des profils différents de ceux utilisés pour les téléchargements de fichiers volumineux.
Pour les déploiements et les redémarrages, je mise sur Graceful-Processus. Grâce à un délai d'expiration progressif bien pensé, les anciens processus se terminent de manière contrôlée tandis que les nouveaux prennent le relais. Ainsi, les connexions „ keep-alive “ restent stables et la file d'attente d'événements traite la charge résiduelle sans interruption brutale. Rotation des fichiers journaux, niveau de verbosité réduit en période de pointe (par exemple „ info “ au lieu de « debug ») et, en option, BufferedLogs réduisent sensiblement la charge d'E/S.
Dépannage en conditions réelles : identifier les schémas récurrents
Symptômes typiques et approches : – Élevé P95/P99- Latences avec des workers libres : il s'agit le plus souvent de temps d'attente côté backend ou réseau ; vérifier les délais d'expiration du proxy et de lecture, ainsi que les pools backend. – „ server reached MaxRequestWorkers “ : parallélisme insuffisant – augmenter MaxRequestWorkers et/ou ThreadsPerChild, vérifier l’empreinte mémoire. – Nombreux Keep-Alive- Connexions, peu de threads actifs, mais système tout de même lent : modules/filtres provoquant souvent des blocages ou goulots d'étranglement au niveau du backend ; profiler la chaîne de filtrage, vérifier la saturation du processeur et les E/S. – Pics 5xx corrélés à la charge TLS : handshakes liés au processeur – optimiser les algorithmes de chiffrement, la reprise de session et, le cas échéant, le déchargement.
Je résous les goulots d'étranglement tout au long de la chaîne : acceptation des sockets (backlog), boucle d'événements (états d'attente), workers (limités par le CPU), filtres (limités par les E/S), proxy (limité par le backend). Ce modèle de réflexion m'évite de modifier le paramètre MaxRequestWorkers alors que c'est en réalité le backend qui est saturé.
Liste de contrôle pratique et écueils courants
Je travaille avec une courte Liste de contrôle: version actuelle d'Apache, MPM « Event » activé, limites correctement dimensionnées, délais d'expiration adaptés. Je vérifie ensuite les taux de Keep-Alive et la relation entre les connexions et les threads actifs. Je m'assure que les modules sont thread-safe et que les filtres ne provoquent pas de longs blocages. Pour PHP via FPM, je m'assure que le nombre de workers FPM est adapté au parallélisme du front-end. De même, je calibre les limites du système d'exploitation telles que les descripteurs de fichiers, le backlog TCP et les paramètres du noyau pour les tampons réseau, afin que la Pipeline ne s'interrompe pas.
Je repère rapidement les écueils courants : des KeepAliveTimeouts trop longs, des MaxRequestWorkers trop faibles, des ThreadsPerChild trop bas ou une journalisation inadaptée. Une journalisation trop détaillée monopolise les E/S et ralentit les réponses. Une taille de pool de backends de proxy trop petite réduit à néant l'optimisation du frontend. Les erreurs de configuration TLS allongent inutilement les handshakes. En réglant correctement ces points, on parvient à créer une fiable La base pour des latences constantes.
Résumé à l'intention des responsables techniques
Event MPM sépare clairement la gestion des connexions et l'exécution, et mise sur une File d'attente des événements, qui gère efficacement les connexions inactives. Apache peut ainsi s'adapter à un grand nombre de clients simultanés sans laisser de threads en suspens. Un bon équilibre entre les paramètres `MaxRequestWorkers`, `ThreadsPerChild` et des délais d'expiration bien choisis permet de maîtriser la latence et la consommation de RAM. Grâce à une surveillance continue, à des tests de performance et à quelques ajustements ciblés, on obtient un système capable d'absorber les pics de trafic et de répondre de manière constante. En suivant ces principes, vous tirerez le meilleur parti de votre Apache- L'installation offre nettement plus de possibilités tout en restant compatible avec les applications et protocoles courants.


