Passer au contenu

Grâce à Traceroute et MTR, tu peux identifier les nœuds qui répondent aux requêtes de diagnostic sur le chemin menant à une destination d'hébergement. MTR répète les requêtes et indique si des anomalies persistent pendant la période de mesure. Un un saut intermédiaire remarquable Cela ne prouve toutefois ni un routeur défectueux, ni une perte de paquets dans le trafic applicatif. Le diagnostic sera plus pertinent si tu notes l'adresse de destination, le protocole et l'heure, et si tu compares les réponses jusqu'à la destination avec le profil d'erreur réel.
Définir l'objectif de mesure et les conditions préalables
Une analyse de traçage efficace commence par une connexion concrète : depuis quel ordinateur le problème se produit-il, quel service est concerné et à quel moment l'erreur apparaît-elle ? Notez l'heure avec le fuseau horaire et décrivez le symptôme, par exemple un chargement lent de la page ou une déconnexion lors de l'accès à un site web.
Garde ça Réseau de sortie fixe, par exemple une connexion à domicile, au bureau, un réseau mobile ou un site de serveurs. Une trace provenant de son propre ordinateur portable répond dans un premier temps à une question différente de celle posée par une trace provenant d'un serveur d'hébergement : les deux partent de points différents et peuvent emprunter des chemins différents pour atteindre leur destination respective.
Pour pouvoir effectuer une comparaison ultérieure, tu auras également besoin de l'adresse IP de destination effectivement utilisée et de la famille d'adresses (IPv4 ou IPv6). Note également l'application concernée et, le cas échéant, son port, par exemple le port TCP 443 pour le protocole HTTPS. Un nom de domaine ne suffit pas à lui seul comme description unique de la mesure s'il peut être résolu en plusieurs adresses.
Dans le cas d'un site web, l'adresse résolue peut correspondre à un CDN ou à un proxy inverse. La mesure indique alors le chemin jusqu'à ce point de terminaison ; la connexion entre ce point et le site proprement dit Serveur Origin Cela ne signifie pas pour autant qu'il est automatiquement vérifié. Vérifie donc si tu contrôles le point de terminaison accessible au public ou une adresse « Origin » spécifiquement autorisée.
Ne testez que vos propres cibles ou celles expressément autorisées à des fins de diagnostic, et convenez de l'étendue et du moment de la procédure pour les services en production ou les systèmes tiers. Vérifie la version de l'outil installée et consulte son aide locale : les options et les droits requis peuvent varier en fonction du système et de l'installation. N'étends pas les autorisations sans vérification préalable, simplement pour lancer une mesure.
Comment Traceroute permet de visualiser le chemin
Traceroute envoie des paquets de test à durée de vie limitée sur le réseau. En IPv4, le champ correspondant s'appelle TTL, ou « Hop Limit » en IPv6. Les routeurs réduisent cette valeur au fur et à mesure ; lorsqu’elle est épuisée, le routeur concerné peut renvoyer une réponse ICMP « Time Exceeded » au système d’origine.
Pour les premières sondes, l'outil définit une valeur faible, puis l'augmente progressivement pour les suivantes. Cela permet à des appareils situés à une plus grande distance de répondre les uns après les autres et d'apparaître comme des « hops ». À destination, la réponse possible dépend de la méthode de sondage choisie ; une trace est donc une représentation des réponses reçues et non une carte complète du réseau.
Un astérisque signifie dans un premier temps simplement qu'aucune réponse appropriée n'est parvenue pour la sonde concernée pendant la fenêtre d'attente. Un routeur peut filtrer les réponses ou ne pas les envoyer, même s’il achemine le trafic. Une réponse perdue est également envisageable ; un seul astérisque n’indique donc ni une défaillance d’un appareil, ni nécessairement une interruption du chemin.
La valeur affichée temps aller-retour comprend le trajet de la requête jusqu'au répondeur concerné et le trajet de retour de sa réponse. Il ne s'agit pas uniquement du temps de transit vers le serveur. Le trajet de retour peut être différent de l'aller, et les appareils peuvent traiter les réponses de diagnostic de manière différente.
Si tu soustrais les temps de deux sauts adjacents l'un de l'autre, tu n'obtiens donc pas une mesure fiable du temps de latence sur la liaison individuelle qui les sépare. Une valeur élevée à une station est une raison d'examiner les réponses ultérieures et d'effectuer d'autres mesures, mais elle ne constitue pas en soi une preuve qu'un routeur est lent.
Distinguer MTR, Traceroute et pathping
Traceroute permet d'obtenir un aperçu rapide des nœuds visibles menant à une destination. Cependant, en cas de perturbation passagère, un seul résultat peut s'avérer insuffisant : il ne montre en effet que les réponses aux requêtes envoyées lors de cette exécution. Une exécution ultérieure peut donner une image différente.
MTR associe le suivi de trajectoire à sondes répétées et compile statistiquement les réponses et les temps de réponse pour chaque saut affiché. Un rapport peut ainsi montrer si un schéma de réponse inhabituel se répète au cours de la période observée. Dans le cas d'une perturbation sporadique, il est particulièrement important de pouvoir établir un lien avec le moment exact où l'erreur s'est produite.
Même un rapport MTR plus long ne constitue qu'un échantillon limité dans le temps. Ses données relatives aux pertes et au temps se rapportent aux paquets de diagnostic utilisés et aux réponses reçues. On ne peut donc pas en déduire d'emblée que tous les paquets d'un site web, d'une connexion à une base de données ou d'une autre application ont été traités de la même manière.
Sous Windows, la commande tracert un indicateur de chemin ; pathping constitue une alternative pour obtenir des statistiques supplémentaires. Ce dernier utilise sa propre méthode de mesure. Ne te contente donc pas de comparer les chiffres issus d'outils différents, mais tiens compte de la durée de la mesure, de l'objectif, du protocole et du contexte de sortie correspondant.
Les sondes peuvent utiliser différents protocoles selon l'outil et les paramètres. Les filtres et les systèmes cibles peuvent y réagir différemment ; une comparaison n'est donc pertinente que si elle s'appuie sur une procédure documentée. Avant de procéder à la mesure, consulte l'aide de la version que tu as installée pour vérifier les options disponibles et les droits requis.
Créer des rapports MTR et des traces
Sous Linux, un bon point de départ reproductible est un Rapport MTR avec des adresses numériques. Dans les exemples suivants, qui ne sont pas exécutés, remplacez example.com par votre propre destination ou par une destination expressément autorisée à des fins de diagnostic. Vérifiez au préalable la version installée localement, son aide et, le cas échéant, les droits requis, plutôt que d'étendre les autorisations sans les avoir vérifiées.
La commande suivante, exécutée dans le terminal Linux, demande un rapport IPv4 avec 100 cycles de mesure. Ces options nécessitent une version de MTR qui les prend en charge ; elles sont décrites dans la documentation de MTR 0.95.
Dans ce contexte, on choisit -4 IPv4, -r le mode rapport et -n l'affichage numérique sans résolution des noms pour les sauts. Avec -c 100 tu définis le nombre de cycles. Conserve la sortie complète ainsi que l'heure de la mesure afin de pouvoir établir des comparaisons ultérieures.
Une centaine de cycles constituent un point de départ raisonnable, mais ne garantissent pas un taux de perte représentatif. Si une erreur ne se produit que rarement, il peut être plus pertinent de disposer de plusieurs rapports datés que de se baser sur l'interprétation d'un seul échantillon. Coordonnez notamment la portée et le moment de vos tests, en particulier pour les cibles externes et les services de production : des tests répétés génèrent du trafic de diagnostic.
Sous Windows, tu peux commencer par créer une trace avec des adresses de saut numériques dans l'invite de commande. Là encore, tu dois remplacer le caractère générique par une destination accessible ; cette option désactive la résolution des noms pour les routeurs affichés.
Cette trace offre un aperçu rapide, mais ne fournit pas de statistiques répétées comparables à celles du rapport MTR. Notez, à côté du résultat, le système source et l'heure. Cela permet de déterminer si deux résultats apparemment différents ont bien été obtenus dans des conditions comparables.
Comparer de manière ciblée IPv6 et TCP
Si le service doit être accessible via les deux familles d'adresses, examinez séparément les adresses IPv4 et IPv6. Notez l'adresse IP de destination concrète utilisée dans chaque cas ainsi que l'heure de la mesure : un nom peut pointer vers différents points de terminaison, et même pour un même service, les paquets peuvent emprunter des chemins réseau différents.
Pour effectuer la comparaison IPv6, utilise la commande suivante dans le terminal Linux. Tu dois disposer d'une destination accessible et d'une version de MTR installée avec les options indiquées ; remplace le caractère de remplacement par ta destination partagée.
Comparez le rapport dès que possible avec le résultat IPv4 et associez les deux au symptôme observé au niveau de l'application. Une différence fournit une indication sur la connexion concernée, mais ne constitue pas une preuve d'une erreur IPv6 générale. L'article consacré à ce sujet décrit d'autres causes possibles dans le contexte de l'hébergement : Problèmes liés à l'IPv6 au niveau du serveur et du réseau.
En cas de problème avec le protocole HTTPS, une deuxième comparaison peut être effectuée avec Sondes TCP vers le port 443. La commande Linux suivante, qui n'est pas exécutée, nécessite une version MTR avec les options TCP et port, et utilise à nouveau une destination spécifiée à la place du caractère générique.
L'option -T sélectionne TCP, -P 443 le port de destination. Si les résultats des sondes ICMP et TCP ne concordent pas, cela peut s'expliquer par des différences dans le traitement des protocoles ou dans le filtrage. La comparaison à elle seule ne permet toutefois pas d'identifier le pare-feu ou l'appareil en cause.
Une réponse à la requête TCP ne constitue pas encore une poignée de main TLS complète et ne prouve pas que le site web diffuse correctement son contenu. Vérifiez donc également le protocole HTTPS à l'aide d'un test d'application adapté. À l'inverse, l'absence de réponse à la requête de test peut être due à une règle et ne prouve pas en soi une défaillance de l'ensemble de l'application.
Bien comprendre la perte de paquets et la latence
Lis un rapport couvrant toutes les étapes jusqu'à la destination et recherche des tendances plutôt qu'une seule ligne qui sort du lot. Affiché Perte de paquets indique dans un premier temps l'absence de réponses aux sondes correspondantes. Il faudra mener d'autres observations pour déterminer si cela révèle un problème au niveau du trafic de l'application.
| Observation | Explication plausible | Ce qui n'en découle pas | Prochaine étape |
|---|---|---|---|
| Défaite sur un seul saut intermédiaire | Le routeur répond aux paquets de diagnostic de manière limitée ou avec une faible priorité. | Le routeur perd inévitablement le trafic qu'il transmet. | Vérifier les étapes suivantes, l'objectif ainsi que le symptôme d'application. |
| Une défaite similaire jusqu'à la fin | Des pertes ou des filtrages peuvent survenir pendant le transfert ou lors des réponses. | Le premier « hop » qui saute aux yeux est sans doute la source d'erreur. | Répétez l'opération rapidement et comparez le résultat avec l'erreur d'application. |
| Pas de réponse ciblée | Il se peut que la cible ou un filtre ne réponde pas à la procédure de sondage. | Le serveur ou l'application est en panne. | Vérifiez séparément le port TCP correspondant et le service. |
| Saut de latence à un saut | Il se peut que la réponse du routeur soit retardée ou qu'il y ait un problème sur une partie du chemin. | Cette différence permet de mesurer de manière fiable le retard d'une liaison individuelle. | Comparer les sauts ultérieurs et la cible ; répéter les mesures. |
Si un nœud intermédiaire répond rarement, alors que les nœuds suivants et la destination répondent, le traitement des réponses par le routeur peut expliquer ce phénomène. Cela ne prouve toutefois pas que chaque flux d'application soit exempt d'erreurs. Si un schéma de pertes similaire persiste jusqu’à la destination, cela constitue une raison plus sérieuse de procéder à une contre-vérification en temps opportun.
Même dans le cas de la Latence C'est l'ensemble du tableau qui compte : si un saut disparaît lors des sauts suivants, il se peut simplement que la réponse du routeur concerné soit retardée. S'il persiste, on peut alors envisager l'hypothèse d'un tronçon de chemin plus lent. Comme chaque temps comprend l'aller et le retour, il n'est pas possible de mesurer précisément la transition individuelle à partir de cela.
Le filtrage et les différents chemins de retour peuvent également influencer les réponses reçues. De plus, la répartition de la charge ou les modifications de routage peuvent mettre en évidence des sauts variables. Ne comparez donc pas aveuglément le même numéro de ligne dans deux rapports : vérifiez d'abord si la destination, le protocole, l'heure de mesure et le chemin affiché correspondent bien entre eux.
Déterminer l'origine des anomalies à l'aide de mesures de référence
Si un site web est lent sur une seule connexion, comparez dès que possible cette connexion avec un deuxième réseau. Utilisez la même adresse IP cible, la même famille d'adresses et le même type de test. Vous réduirez ainsi les écarts dus uniquement à des différences de cibles ou de méthodes de mesure ; notez néanmoins l'heure et le réseau de départ pour les deux rapports.
Un résultat différent provenant du deuxième réseau peut restreindre l'espace de recherche, mais ne prouve pas pour autant qu'il y ait une erreur au niveau de la première connexion. Les réseaux de départ peuvent emprunter des chemins différents pour atteindre la destination ; des variations temporelles ou un traitement différent des sondes sont également à prendre en compte. Vérifie donc si cette différence se reproduit et si elle survient en même temps que l'utilisation en mode lent.
Si le serveur est accessible en principe, mais que le protocole HTTPS pose des problèmes, comparez les sondes ICMP avec Sondes TCP vers le port effectivement utilisé. Des réponses divergentes peuvent indiquer un traitement ou un filtrage lié au protocole. Cela ne permet toutefois pas à lui seul de déterminer quel composant précis en est responsable.
Effectuez également un test d'application HTTPS distinct et notez si, par exemple, l'établissement de la connexion échoue ou si une page met du temps à répondre. Une requête TCP vers le port 443 ne reproduit ni la procédure complète de négociation TLS, ni le traitement d'une requête HTTP. Un port accessible ne signifie donc pas que le site web fonctionne correctement.
En cas de coupures sporadiques, plusieurs solutions sont possibles Mesures comparatives pendant et en dehors de la fenêtre d'erreur. Notez à chaque fois la durée et le nombre de sondes : une réponse manquante sur 100 sondes correspond mathématiquement à un point de pourcentage dans cet échantillon. Il ne s'agit ni d'une mesure à part entière, ni d'une indication sur le taux de perte à long terme.
Préparer les mesures correctives et le ticket d'assistance
Une mesure effectuée du serveur vers l'adresse IP du client complète la trace du client vers le serveur. Elle analyse le chemin sortant du serveur à l'aide de ses propres sondes et réponses. Même si les mêmes adresses sont impliquées, elle ne permet pas de reconstituer de manière fiable le chemin de retour de la trace d'origine : le routage et le comportement des réponses peuvent varier selon le sens.
Pour une solution viable contre-mesure L'adresse de destination et l'instant de la mesure doivent être fixés. Vérifie quelle adresse IP publique du client est utilisée pendant la panne et si un diagnostic vers cette adresse est autorisé et pertinent. Un pare-feu peut ne pas répondre aux sondes sélectionnées ; dans ce cas, le résultat ne prouve pas à lui seul une panne du client.
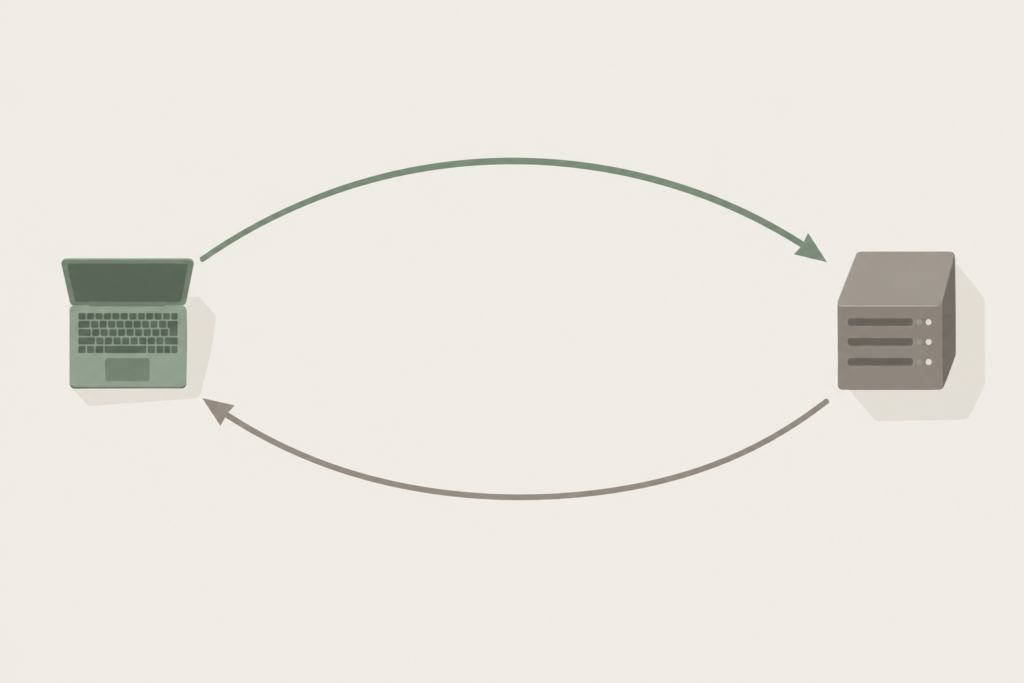
Si vous n'avez pas accès au serveur, demandez à l'hébergeur d'effectuer une mesure de contre-vérification par rapport à l'adresse IP du client concerné. Indiquez la fenêtre d'erreur et l'application concernée afin que le support technique puisse sélectionner une mesure appropriée et situer le résultat dans le temps. Si nécessaire, coordonnez l'étendue et le moment de la mesure plutôt que de générer en permanence du trafic de diagnostic sans y avoir été invité.
Pour le Ticket d'assistance Des rapports complets et non modifiés sont plus utiles qu'un simple saut mis en évidence. Précisez le contexte et décrivez ce qui se passe réellement dans l'application. La liste de contrôle suivante vous aidera à classer les résultats de manière reproductible :
- Adresse IP source et destination, famille d'adresses, ainsi que réseau source ou emplacement du serveur.
- Outil utilisé, si possible sa version, le protocole de sondage et, le cas échéant, le port de destination.
- Rapports complets indiquant la date et l'heure, le fuseau horaire, ainsi que le nombre de cycles ou la durée de la mesure.
- Symptômes concrets liés à l'application, fréquence et fenêtre d'erreur observée ; le cas échéant, rapports de comparaison pertinents.
Les rapports peuvent contenir des adresses publiques et internes ou d'autres informations relatives au réseau. Ne communiquez les informations confidentielles que par un canal de support approprié et signalez, le cas échéant, les informations qui ont été délibérément supprimées. En revanche, un simple chiffre indiquant une perte, sans précision quant à la cible, au moment ou au protocole, ne permet guère de l'associer de manière pertinente à un incident.
Étapes suivantes après la vérification du réseau
Si les anomalies récurrentes coïncident dans le temps avec l'erreur d'application, il convient de procéder à une analyse approfondie du chemin réseau et des filtres éventuels. Pour ce faire, comparez les protocoles et les sens de mesure, puis transmettez les résultats aux opérateurs concernés. Le premier saut anormal ne permet à lui seul ni de prouver la présence d’un routeur défectueux, ni d’identifier clairement le fournisseur d’accès responsable.
A rapport discret n'exclut pas un problème d'hébergement : il décrit uniquement les réponses aux sondes utilisées pendant la période de mesure. Vérifie ensuite, en fonction du symptôme, la résolution du nom, l'établissement de la connexion TLS et la réponse HTTP. Note bien l'adresse de destination et l'heure afin de pouvoir comparer les résultats avec le rapport réseau.
Si HTTPS renvoie une réponse, mais que certaines fonctions restent lentes ou échouent, examinez également l'application et ses dépendances, telles que les accès à la base de données. Lors de l'accès au serveur, vous pouvez bpftrace pour le diagnostic côté serveur fournir des informations complémentaires sur les processus et les événements du noyau. Cela ne remplace toutefois pas la mesure du chemin entre le client et le serveur.
En cas de problèmes de transfert liés à la taille, pensez également à la MTU: Les petits tests standard ne suffisent pas pour exclure de manière générale ce type d'erreurs. Si des paquets plus volumineux ou des messages d'erreur filtrés sont susceptibles d'entrer en ligne de compte, considérez les tests MTU approfondis comme une étape de diagnostic à part entière et coordonnez-les avec les opérateurs concernés.
Ne modifiez pas plusieurs composants à la fois simplement parce qu'un rapport semble anormal. Commencez par documenter votre hypothèse, effectuez un test individuel adapté et comparez-le au profil d'erreur initial. Cela permet de déterminer clairement si une mesure a eu un impact sur le problème observé ou si elle a simplement modifié un élément isolé du diagnostic.
Sources et état des connaissances
État de la recherche :
Sources et options de l'outil d'après la recherche effectuée le 13 novembre 2026 ; les exemples MTR se réfèrent aux options documentées de la version 0.95. Vérifiez la version installée et l'aide locale avant utilisation.
https://github.com/traviscross/mtr/blob/v0.95/man/mtr.8.in
https://www.cloudflare.com/en-ca/learning/network-layer/what-is-mtr/
https://developers.cloudflare.com/speed/troubleshooting/slow-website/
https://man7.org/linux/man-pages/man8/traceroute.8.html
https://www.rfc-editor.org/info/rfc792/
https://learn.microsoft.com/en-us/windows-server/administration/windows-commands/tracert
https://learn.microsoft.com/en-us/troubleshoot/windows-client/networking/diagnose-packet-loss