 Passer au contenu

L'Apache Scoreboard m'indique en temps réel combien de workers sont en train de lire des requêtes, d'envoyer des réponses ou d'être inactifs, et cela me permet d'évaluer la Charge du serveur sans avoir à deviner. Grâce à mod_status, j'accède de manière structurée aux données d'état, j'interprète les symboles, je mesure le débit et j'en tire des conclusions concrètes Étapes de réglage à partir de
Points centraux
- Statut en temps réel comprendre tous les travailleurs et identifier rapidement les goulots d'étranglement.
- mod_status Mettre en place cette fonctionnalité en toute sécurité et tirer pleinement parti d'ExtendedStatus.
- Chiffres clés analyser systématiquement des indicateurs tels que Req/s, Busy/Idle et CPU.
- Symboles interpréter les données du tableau de bord et agir de manière ciblée.
- Suivi automatiser et définir des alertes en fonction des données.
Qu'est-ce que l'Apache Scoreboard ?
Dans le tableau de bord, Apache enregistre pour chaque worker un état actuel (tel que « Lecture », « Envoi » ou « Inactif »), ce qui me permet de voir les Répartition des tâches des processus. Les données sont disponibles en interne et sont transmises à l'interface via mod_status, au choix au format HTML ou en mode lisible par machine. J'y vérifie les workers occupés, les workers inactifs, la charge CPU, la durée de fonctionnement ainsi que les accès et les octets. Je trouve particulièrement utile la vue très détaillée sur chaque worker, car elle me permet d'identifier la durée de traitement et l'hôte actif. Je peux ainsi déterminer en toute connaissance de cause s'il y a un manque de capacité, si les requêtes prennent trop de temps ou si des slots Keep-Alive sont bloqués ; cela Transparence permet de gagner du temps lors de l'analyse des causes.
Voici comment j'y accède via mod_status
Avec /server-status, j'ouvre une page HTML claire ; avec /server-status?auto, j'obtiens un affichage textuel concis pour Suivi et des scripts. Dans les environnements de production, j’active ExtendedStatus, car les métriques supplémentaires fournies par chaque worker m’apportent le contexte nécessaire. Je limite strictement l’accès aux réseaux d’administration ou à des hôtes spécifiques et je ne rends pas la page publique. Pour une inspection manuelle, une brève session de navigation suffit ; en cas de surveillance continue, j’intègre la vue automatique dans un système de surveillance. Je réduis ainsi la charge système au minimum et garantis la données de statut de manière judicieuse.
Évaluer la configuration sécurisée et la surcharge
Je protège systématiquement /server-status et je choisis, en fonction de la situation, entre l'autorisation d'accès par IP, l'authentification ou un VHost d'administration interne. ExtendedStatus entraîne une charge mesurable, mais négligeable dans la pratique. Overhead; je l'active de manière permanente si j'utilise également les données dans le suivi, ou seulement de manière temporaire pour des analyses ponctuelles. Une configuration type claire m'aide à éviter les erreurs :
Activer #
ExtendedStatus On

Rendre l'état # accessible uniquement en interne

  SetHandler server-status

  # Variante 1 : basée sur l'adresse IP
  Require ip 10.0.0.0/8 192.168.0.0/16 ::1

  # Variante 2 : authentification de base (par exemple, en plus de l'adresse IP)
  #AuthType Basic
  #AuthName " Server Status "
  #AuthUserFile " /etc/httpd/conf/.htpasswd "
  #Require valid-user
Je veille à ce que la page reste accessible en dehors des VHosts de production (par exemple via une adresse interne), afin qu'aucune règle de réécriture ni aucun routage proxy ne vienne perturber le processus. À la fin des phases de débogage, je m'assure que seules les informations indispensables sont publiées.
Comprendre rapidement les symboles du tableau d'affichage
En cas de dysfonctionnement, je regarde d'abord les symboles, car une succession dense de R et de W indique une charge intense, tandis que de nombreux _ signalent le repos ; ceux-ci Codage accélère le diagnostic. K m'indique également les connexions Keep-Alive ouvertes qui se lient aux workers en cas de délai d'expiration inadapté. Une concentration sur D indique des requêtes DNS qui retardent les réponses. Des entrées L fréquentes suggèrent un blocage au niveau de la journalisation et des sous-systèmes de stockage. En quelques coups d'œil, j'identifie ainsi le goulot d'étranglement principal et lance des mesures ciblées Mesures.
| Symbole | Signification | Avis immédiat |
|---|---|---|
| _ | Travailleur inactif | Suffisante Capacité disponible |
| R | Demande de lecture | Vérifie la latence du réseau ou Client |
| W | Envoi de la réponse | Temps de traitement côté serveur et taille de la sortie analyser |
| K | Keep-Alive | Délais d'expiration et attribution des slots vérifier |
| D | Recherche DNS | Désactiver le DNS inversé ou mettre en cache |
| L | Enregistrement | Enregistrement asynchrone et E/S vérifier |
| C | Clôture | Fin normale de la connexion, en bref visible |
| G | Une finition raffinée | Demande terminée, worker déblaye à l'adresse suivante : |
| I | Nettoyage en mode veille | Non critique, Worker ajusté |
| . | Inactif | Période calme, ressources libre |
Détecter des modèles et des profils d'attaque avancés
Je n'évalue pas seulement des situations ponctuelles, mais aussi les Durée et la répartition des symboles. De nombreux états R de longue durée associés à une faible bande passante réseau indiquent la présence de clients lents ou d’un schéma Slowloris ; dans ce cas, je limite les temps de lecture par requête (par exemple avec RequestReadTimeout) et je définis des débits minimaux réalistes. Si les états W prédominent avec un nombre élevé d’octets par requête, c’est plutôt la bande passante ou le stockage qui constitue le goulot d’étranglement. Des accumulations simultanées d’états D et L m’amènent à donner la priorité à la résolution des noms et aux E/S de journalisation. Ce qui est déterminant, c’est de savoir si les schémas large (tous les travailleurs) ou local (un seul VHost ou chemin d'accès) – cela me permet de repérer plus rapidement les points sensibles dans l'application.
Indicateurs clés pour l'analyse des serveurs Web
Le nombre de requêtes par seconde me donne un aperçu du débit, mais j'évalue en parallèle le nombre d'octets par seconde et le nombre d'octets par requête pour la charge utile. Le rapport « occupé/inactif » permet de déterminer s'il manque des slots ou si les paramètres sont trop conservateurs. Je mets en corrélation l’utilisation du processeur avec les temps de réponse afin de distinguer les cas liés au processeur de ceux liés aux E/S. Le temps de disponibilité permet de différencier les redémarrages récents des tendances réelles. À partir de cette combinaison, je détermine des leviers de réglage concrets pour les workers, le keep-alive et Timeouts à partir de
Seuils et alertes dans la pratique
Je ne configure pas les alertes sur la base des valeurs instantanées, mais sur celle des moyennes mobiles et Durée. Les heuristiques suivantes, par exemple, ont fait leurs preuves : une valeur Idle 4:1 sur la même période suggère une saturation. Si le nombre de requêtes par seconde (Req/s) diminue alors que le trafic reste constant et que le taux d’occupation (Busy) reste stable, cela est souvent dû à un problème au niveau du backend. Une proportion K > 50 % aux heures de pointe indique un keep-alive trop généreux. J’ajoute aux seuils des alertes de tendance (temps de réponse en hausse à charge égale) et Saisonnalité (rythmes quotidiens et hebdomadaires), afin de pouvoir distinguer les changements réels du comportement normal.
Claser correctement le fichier « ScoreboardFile »
Sur certaines plateformes, Apache enregistre les données d'état dans un fichier « scoreboard », que je place dans un répertoire rapide et sécurisé tel que /var/run/httpd ; cela améliore la Fiabilité. J'empêche plusieurs instances d'utiliser le même fichier, sinon cela risquerait d'entraîner des valeurs erronées. Certains outils lisent directement le fichier, ce qui rend le point de terminaison HTTP superflu. C’est intéressant en termes de sécurité et de performances, à condition que les autorisations soient correctes. Je documente le chemin d’accès et les droits d’accès afin de faciliter la maintenance et Suivi rester cohérent.
Particularités du système d'exploitation et des conteneurs
Je m'assure que les limites des descripteurs de fichiers, les files d'attente et les chemins temporaires sont adaptés à la charge de travail. Sous systemd, je vérifie si les paramètres PrivateTmp ou ReadOnlyPaths ont une incidence sur le chemin du Scoreboard. Dans les conteneurs, j’estime de manière prudente les besoins en mémoire par processus/thread et je définis le chemin Scoreboard dans un répertoire accessible en écriture Répertoire d'exécution. En cas de pic de charge, j'ajuste les paramètres du noyau :
# Exemples de valeurs sysctl (à tester et à documenter à l'échelle du système)
net.core.somaxconn = 4096
net.ipv4.tcp_max_syn_backlog = 4096
fs.file-max = 1048576
De plus, je règle la valeur de `ulimit -n` pour le service Apache de manière à ce qu’elle corresponde à la valeur maximale simultanéité convient (règle empirique : FD ouverts ≈ 2 à 3 × MaxRequestWorkers dans les configurations à forte utilisation de proxy). Après avoir apporté des modifications, je consulte à nouveau le tableau de bord pour vérifier les effets.
Cas d'utilisation typiques : détecter les travailleurs surchargés
Si presque tous les emplacements sont occupés par R ou W et qu'il n'y a pratiquement pas d'entrées _‑, le serveur atteint sa Limite. Je vérifie ensuite le paramètre `MaxRequestWorkers`, les temps de réponse et les backends bloquants. Si l'ajout de workers supplémentaires ne résout pas le problème, le goulot d'étranglement se situe souvent au niveau de l'application, de la base de données ou du stockage. Grâce à /server-status?auto, je suis l’évolution à intervalles réguliers, plutôt que de me contenter d’analyser des instantanés. Cela me permet de décider s’il faut ajuster les paramètres, renforcer la mise en cache ou Mise à l'échelle planifier.
Modèle de ressources et formules de capacité
Je calcule les capacités à l'avance afin d'éviter tout goulot d'étranglement au niveau de la mémoire. Pour Prefork, on a : Mémoire ≈ nombre de processus × RSS par processus. Pour Worker/Event : Mémoire ≈ nombre de processus × (RSS par processus) + threads × surcoût par thread. Je mesure le RSS réel à l'aide des outils du système et je prévois des marges de sécurité. Un petit exemple : 20 processus × 50 Mo + 500 threads × 1 Mo donnent ≈ 1,5 Go, plus le cache et les tampons du système d’exploitation. À partir de là, je détermine les valeurs de MaxRequestWorkers, ServerLimit et ThreadsPerChild. Je tiens également compte du fait que des modules tels que SSL, PHP ou le proxy inverse augmentent la mémoire par fil de discussion peuvent augmenter ; c'est pourquoi je réalise mes essais avec une charge utile réelle, et pas seulement à vide.
Interpréter les files d'attente et la latence
Lorsque les requêtes restent longtemps à l'état « Accept » ou « Écriture », la latence perçue augmente, et je me penche alors sur la longueur des files d'attente ainsi que sur le backlog « Accept » ; le tableau de bord fournit à cet égard de précieuses Indicateurs. Cet article m'apporte des explications plus détaillées sur les files d'attente, les latences et le traitement des requêtes : Files d'attente et latence. À partir de ces éléments, je détermine si les goulots d'étranglement se situent en amont, au niveau d'Apache ou en aval. Je tolère les pics de trafic de courte durée, mais je remédie aux engorgements persistants en augmentant la capacité ou en modifiant l'architecture. J'évite ainsi que les délais d'expiration ne s'aggravent et que les clients interrompre.
Établir une connexion au backend et au proxy
Dans les environnements à forte utilisation de proxy, je déduis, à partir des phases W, si les workers sont sur Flux en amont Attendre. ExtendedStatus m'indique le VHost et la ressource demandée ; cela me permet de mettre en corrélation les chemins d'accès avec les backends lents. Je définis des délais d'expiration réalistes (TimeOut, ProxyTimeout) et je vérifie la gestion du pool de connexions afin d'éviter que les threads ne se bloquent inutilement. Si le pipeline est saturé lors des envois, je régule les débits de lecture par client et me protège contre les expéditeurs lents. Si de nombreuses réponses volumineuses sont générées, j’envisage la compression, le chunking et Mise en cache à envisager afin de réduire les délais W.
Configurer le « Keep-Alive » de manière ciblée
De nombreuses entrées « K » indiquent que des clients laissent des connexions ouvertes ; cela accélère les requêtes suivantes, mais peut occuper des slots lier. Je configure les délais d'expiration de manière à ce que les véritables requêtes répétées en bénéficient, sans pour autant bloquer trop longtemps les périodes d'inactivité. Sur les sites très fréquentés, j'utilise un proxy en amont qui regroupe efficacement les requêtes « Keep-Alive ». Pour plus de détails sur le réglage fin, je me réfère à ce guide : Configurer le délai d'expiration Keep-Alive. Avec un délai d'expiration raisonnable, l'occupation des slots diminue et le serveur reste opérationnel même sous charge réactif.
Interaction entre HTTP/2, TLS et MPM
Avec HTTP/2, j'observe généralement moins de « K-binding » par client, car plusieurs flux partagent une même connexion partager. C'est là qu'Event-MPM montre tout son potentiel : la gestion du Keep-Alive est plus efficace, et le travail actif reste réservé aux threads. Le protocole TLS augmente la charge CPU par connexion ; je vérifie s'il existe une corrélation entre des proportions élevées de W et une charge CPU élevée, puis j'optimise les suites de chiffrement ainsi que la reprise de session. Dans les vues d’état, je détermine pour chaque VHost si les chemins de terminaison HTTP/2 ou TLS dominent et j’adapte les capacités en conséquence (par exemple, davantage de threads plutôt que de processus lorsque les changements de contexte sont coûteux).
Maîtrise des requêtes DNS et de la journalisation
Si la lettre « D » apparaît fréquemment dans le tableau de bord, je vérifie le DNS inversé et j’active un cache local ou je désactive les requêtes de résolution ; cela réduit le Latence. Si je constate un grand nombre d’entrées « L », la journalisation ralentit le traitement ; je répartis donc les fichiers journaux, j’utilise un stockage plus rapide ou des pipelines asynchrones. Je configure les journaux à rotation de manière à éviter les pics de vidage. En parallèle, je mesure les E/S d'écriture et les verrous de fichiers afin de briser les schémas bloquants. Je gagne ainsi du temps de traitement et je soulage le Travailleur.
Intégration dans les systèmes de surveillance
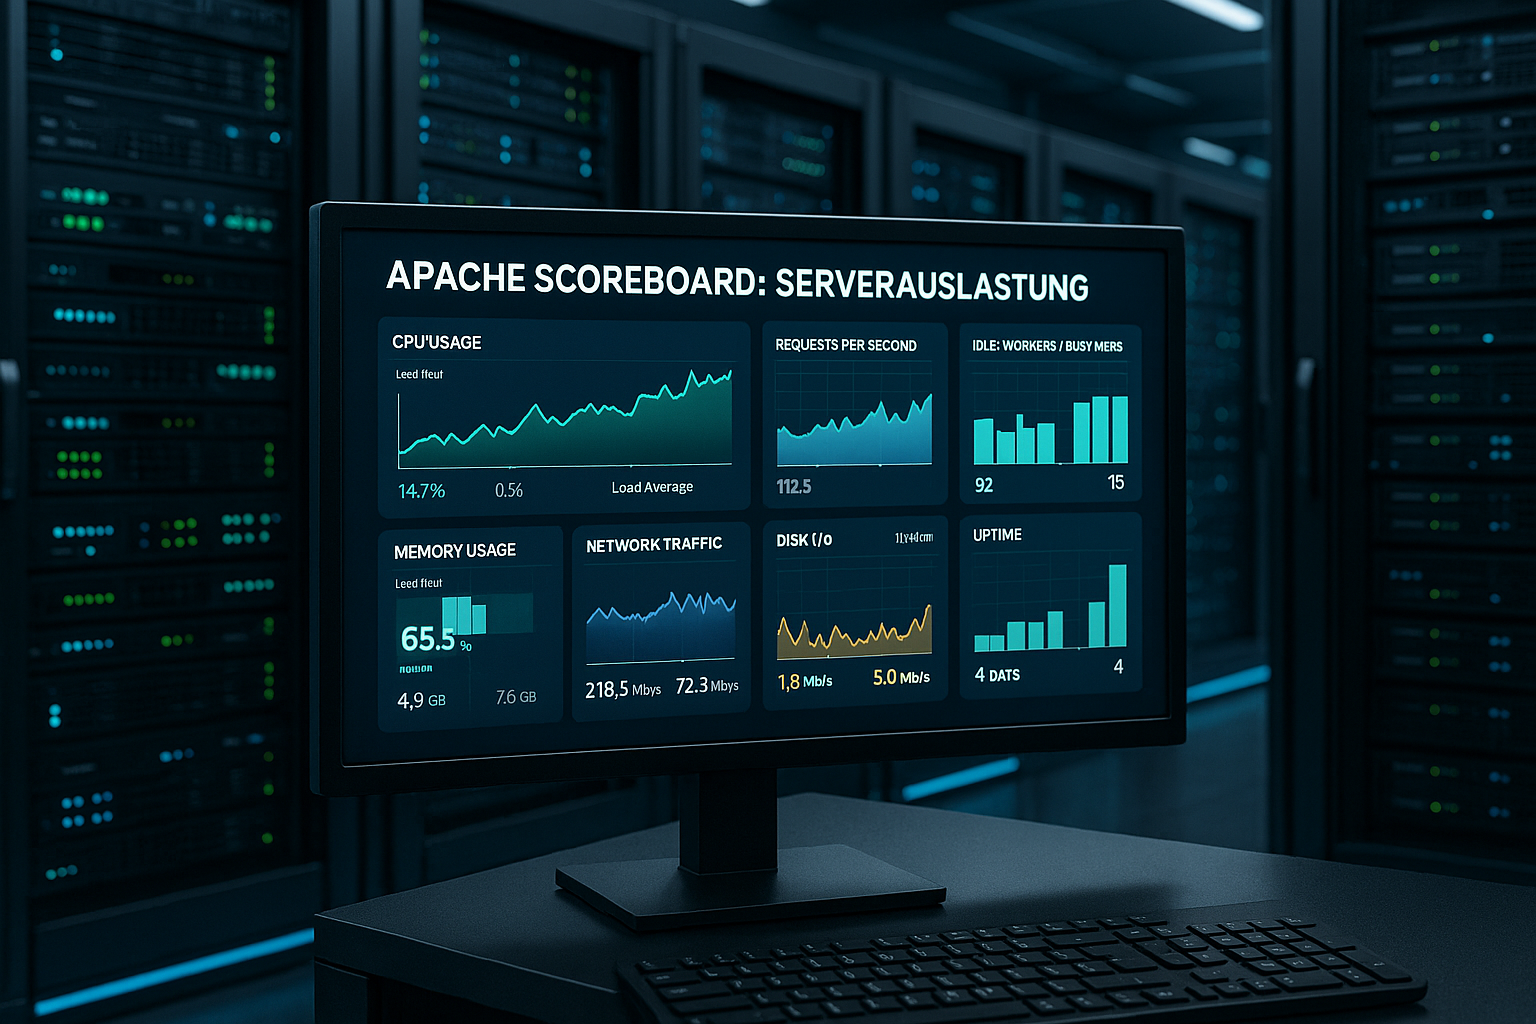
Je collecte périodiquement les données /server-status?auto, j'enregistre les valeurs sous forme de séries chronologiques et je visualise les indicateurs « Busy vs Idle », « Req/s », « Bytes/s » et « Charge CPU » sur Tableaux de bord. Les alertes définissent des seuils pour les slots constamment pleins, l'augmentation des temps de réponse ou les modèles de trafic inhabituels. Grâce aux annotations, je marque les déploiements afin de voir immédiatement leurs effets. Cet historique permet de distinguer les pics ponctuels des véritables tendances. Je peux ainsi gérer la capacité de manière planifiée et éviter Surprises.
Saisie automatisée à l'aide de scripts
Pour des vérifications rapides, un script léger qui analyse la vue « Auto » et n’affiche que les chiffres clés me suffit. Je maintiens des intervalles de requête modérés (par exemple, 10 à 30 secondes) afin de limiter la charge système, et je balise chaque échantillon avec l'hôte, le VHost et l'environnement.
#!/bin/sh
URL="http://127.0.0.1/server-status?auto"
curl -s "$URL" | awk -F': ' '
  /BusyWorkers/ {busy=$2}
  /IdleWorkers/ {idle=$2}
  /ReqPerSec/   {rps=$2}
  /BytesPerSec/ {bps=$2}
  END { printf("busy=%s idle=%s rps=%.2f bps=%.0f\n", busy, idle, rps, bps) }
'
Dans les environnements de grande envergure, j'agrège également les temps par worker, je les attribue à des VHosts et je calcule Quantile pour les temps de réponse. Cela me permet de déterminer si seuls certains utilisateurs rencontrent des problèmes ou si la majorité est concernée.
MPM et planification des capacités
Le MPM définit la manière dont Apache traite les connexions ; les données du Scoreboard m'indiquent si ce sont les processus ou les threads qui constituent le facteur limitant facteur . Pour la sélection et l'optimisation, je compare les événements et les workers, je mesure les temps d'inactivité, la durée des keep-alive et les changements de contexte. Cet article propose une comparaison concise : MPM « Event » vs « Worker ». Après avoir apporté des modifications, je vérifie à nouveau les indicateurs « Busy/Idle » et « Req/s » afin de constater les effets. Cela me permet de prendre des décisions fondées sur des données et d'augmenter la Efficacité.
Redémarrage en douceur, déploiements progressifs et maintenance
Lors de déploiements ou de modifications de configuration, je préfère déclencher un graceful Redémarrage désactivé. Dans le tableau de bord, je le remarque à la présence de nombreux états G, tandis que les nouveaux processus démarrent et que les anciens s'arrêtent proprement. Je planifie les changements progressifs de manière à conserver une capacité inutilisée suffisante : je réduis d'abord la charge, puis je relance en douceur, avant de passer aux nœuds restants. Des phases « G » prolongées indiquent que d’anciens processus attendent des requêtes lentes ; je vérifie alors les délais d’expiration et les paramètres Keep-Alive afin de réduire le temps de basculement.
Pas à pas vers une analyse approfondie
J'active mod_status, je sécurise l'accès et j'active ExtendedStatus afin de pouvoir voir tous les Détails obtiens. Ensuite, je vérifie la page HTML dans le navigateur et j’apprends le comportement en temps réel des icônes. À l’étape suivante, j’intègre /server-status?auto dans mon système de surveillance et je valide les métriques. Ensuite, j’optimise les éléments les uns après les autres : nombre de workers, keep-alive, délais d’expiration, mise en cache et chemins d’accès à l’application. Je mesure à nouveau chaque modification jusqu’à ce que le nombre de requêtes par seconde (Req/s), le temps de réponse et les taux d’activité/d’inactivité reviennent dans la espace vert sont couchés.
Résumé : Apache Scoreboard, une boussole
Le tableau de bord Apache me fournit une vue claire et immédiatement exploitable sur la charge, les goulots d'étranglement et le comportement des Travailleur. Grâce à mod_status, ExtendedStatus et une surveillance rigoureuse, je transforme les données brutes en décisions fiables. Les indicateurs et les métriques me permettent de déterminer s’il faut augmenter la capacité, réduire les délais d’expiration ou intervenir directement sur l’application. Une petite modification du Keep-Alive ou du MPM peut avoir un impact considérable si les données sont correctes. En interprétant correctement les signes, on maintient Apache sous charge. réactif et planifiable.


