Passer au contenu

Les indicateurs P95 et P99 mettent en évidence les requêtes lentes qui peuvent masquer une valeur moyenne. Un P95 décrit, en simplifiant, la durée que n'excèdent pas environ 95 % des requêtes sélectionnées. La signification de cette donnée dépend du point de mesure, de la période et du volume de requêtes enregistrées. Les histogrammes fournissent à cet effet des estimations dont la précision dépend de leur résolution. Pour obtenir une vision fiable de l'exploitation, il faut également tenir compte du volume de requêtes et du taux d'erreur ; un centile à lui seul n'explique ni la cause d'un retard, ni l'expérience vécue par chaque individu.
Ce que recouvre la mesure de la latence
Un indicateur de latence n'est compréhensible que si vous Point de mesure C'est un fait établi. Un proxy inverse peut enregistrer la durée d'une requête au moment de son passage vers le service ; une application, en revanche, mesure une partie de son propre traitement. Les étapes incluses dans chaque cas dépendent du point de départ et du point d'arrivée de la mesure.
Une mesure effectuée dans le navigateur peut également prendre en compte certaines parties du trajet entre le client et le serveur, ainsi que le traitement côté client. Là encore, ce sont les paramètres de mesure spécifiques qui déterminent le début et la fin. Une faible latence côté serveur ne suffit donc pas à elle seule à prouver qu’une page est rapidement accessible dans le navigateur : la transmission réseau et le traitement sur le terminal peuvent prendre du temps supplémentaire.
Place également la Population Précisez : s'agit-il de toutes les requêtes d'un service ou d'un point de terminaison spécifique ? La répartition globale peut différer de celle d'un point de terminaison individuel. Précisez également si l'analyse porte sur une fenêtre glissante de cinq minutes ou sur une période plus longue, et si les valeurs sont affichées en secondes ou en millisecondes.
Les requêtes réussies et celles qui ont échoué font également partie de la définition. Une erreur renvoyée rapidement peut améliorer la distribution de la latence, même si la requête n'a pas atteint sa destination. Des vues distinctes pour les succès et les échecs permettent d'identifier ces cas ; de plus, le taux d'échec reste un indicateur opérationnel à part entière.
La convention OpenTelemetry de la branche de développement décrit, pour les serveurs HTTP, un histogramme de la durée des requêtes en secondes. Cela ne signifie pas pour autant qu'une version installée donnée le prenne en charge ou l'exporte sous le même nom. Vérifie dans ton environnement le nom réel de la métrique et les attributs disponibles avant de créer un tableau de bord à partir de celle-ci.
Bien lire les codes P95 et P99
A percentile décrit une limite au sein de la distribution sélectionnée. Si P95 est égal à 400 millisecondes, cela signifie, en simplifiant, qu’environ 95 % des durées de requêtes prises en compte ne dépassent pas cette valeur. P99 se concentre davantage sur la partie la plus lente de la distribution : il décrit ainsi la limite pour environ 99 % des observations.
| Chiffre clé | Témoignage | Limites de cette affirmation |
|---|---|---|
| Moyenne | Somme des durées divisée par le nombre de requêtes | Masque la répartition des requêtes individuelles rapides et lentes |
| P50 | Seuil correspondant à environ la moitié des durées observées | Ne précise pas à quel point la partie supérieure est lente |
| P95 | Limite pour environ 95 % des durées observées | Les observations plus lentes situées au-dessus de la limite restent invisibles dans une valeur isolée |
| P99 | Limite pour environ 99 % des durées observées | Lorsque le nombre d'observations est faible, les résultats peuvent dépendre fortement de certaines valeurs isolées |
Ces pourcentages se rapportent à des valeurs mesurées, et non directement à des personnes ou à des sessions. Une personne peut générer plusieurs requêtes, tandis qu'une autre n'en envoie qu'une seule. On ne peut donc pas déduire d'un P99 seul qu'un pour cent des utilisatrices et utilisateurs a connu une session lente.
La limite exacte dépend en outre de la méthode de calcul. Lorsque les valeurs mesurées sont identiques ou lorsque la position souhaitée se situe entre deux observations, différentes définitions des quantiles peuvent donner lieu à des choix ou à des interpolations différents. Dans le cas de valeurs d'histogramme estimées, il faut ajouter la répartition en tranches ; une valeur affichée ne correspond donc pas toujours à une durée individuelle réellement observée.
En matière de surveillance de l'hébergement, le volume de requêtes et le taux d'erreur font partie du centile. Cette même valeur P99 doit être interprétée différemment selon que le nombre de requêtes est faible ou élevé ; sans données sur le volume, il est difficile d'évaluer sa stabilité. Le taux d'erreur met en outre en évidence un aspect qu'une simple distribution temporelle ne reflète pas de manière fiable.
Comment les histogrammes permettent d'estimer les centiles
Un histogramme Prometheus classique ne stocke pas de liste triée de toutes les durées de requêtes. Il comptabilise les observations dans tranches cumulées: Un groupe ayant un seuil maximal donné comprend également les observations qui se situent déjà dans des groupes inférieurs. Ces chiffres permettent d'estimer dans quelle partie de la distribution se situe un centile recherché.
Supposons que la position recherchée se situe entre 200 et 500 millisecondes. L'histogramme indique le nombre d'observations recensées jusqu'à ces limites, mais pas leur répartition exacte entre celles-ci. Pour les histogrammes classiques, Prometheus estime la position au sein de ce intervalle par interpolation linéaire.
Cette estimation peut s'écarter des valeurs individuelles réelles. En particulier, une fourchette large autour d'une valeur seuil importante sur le plan opérationnel laisse une grande marge d'incertitude : la répartition des observations au sein de cette fourchette pourrait être différente de celle supposée lors de l'interpolation. Des limites plus étroites dans les plages pertinentes améliorent la résolution, mais entraînent un surcroît de travail lié au traitement des données.
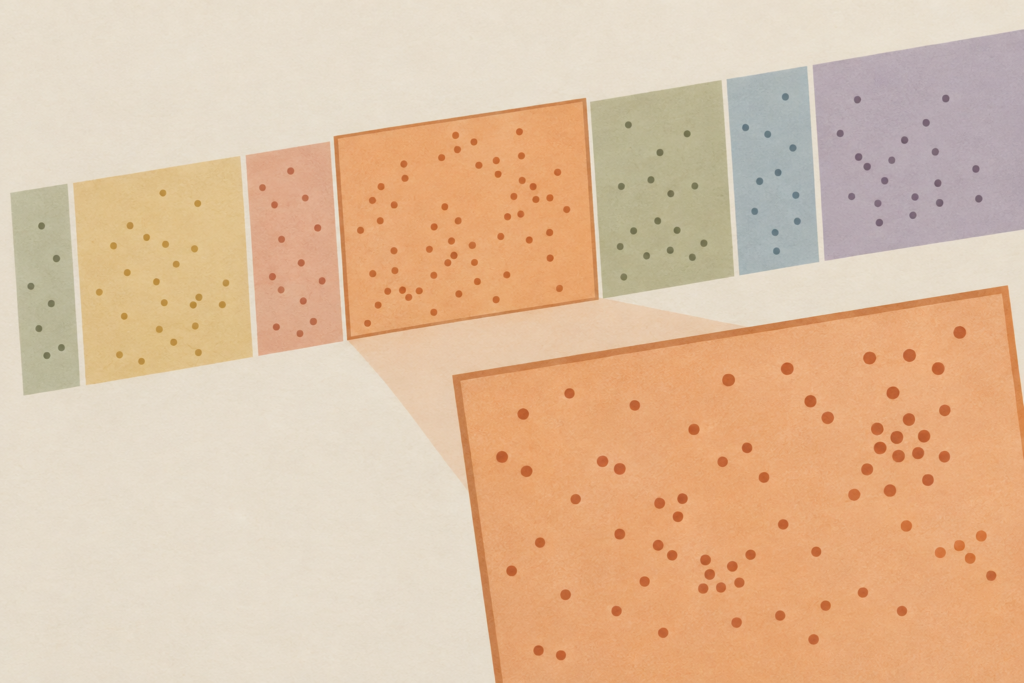
Les histogrammes natifs utilisent une représentation différente de celle des séries chronologiques classiques par tranches. Leurs quantiles sont également des estimations ; les Interpolation Cela dépend du schéma et du compartiment utilisés. Les histogrammes classiques et natifs ne doivent donc pas être considérés comme ayant le même mode de stockage et toujours les mêmes règles d'interpolation.
Quantile peut déjà calculer un résumé au cours du processus instrumenté. Cependant, ces valeurs de quantiles obtenues ne peuvent pas être regroupées a posteriori pour former un quantile global correct couvrant plusieurs processus. Pour une analyse commune des instances, les données d’histogramme agrégables constituent donc souvent une base plus appropriée ; les limites des tranches doivent alors correspondre au niveau de synthèse souhaité.
Quand la moyenne masque les valeurs aberrantes
Exemple de calcul à titre illustratif, et non une mesure : au cours d'un intervalle de temps donné, 95 requêtes durent chacune 100 millisecondes et cinq autres durent chacune 2 000 millisecondes. Les 100 observations appartiennent toutes à la même population sélectionnée. Cet exemple sert à comparer des indicateurs et ne constitue pas une preuve des performances d'un système d'hébergement.
Pour les centiles, nous utilisons ici une valeur concrète règle de sélection: On recherche dans chaque cas la plus petite valeur observée pour laquelle au moins la proportion indiquée des requêtes se situe à ce niveau ou en dessous. Une fois triées, on obtient d'abord 95 valeurs de 100 millisecondes, puis cinq valeurs de 2 000 millisecondes.
| Chiffre clé | Calcul ou sélection | Résultat |
|---|---|---|
| Moyenne | (95 × 100 ms + 5 × 2 000 ms) / 100 | 195 ms |
| P95 | 95. valeur triée | 100 ms |
| P99 | 99e valeur triée | 2 000 ms |
Le Moyenne est nettement inférieure à la durée des cinq requêtes lentes. Il répartit mathématiquement ce temps supplémentaire sur l'ensemble des observations. En ne tenant compte que de cette valeur, on ne peut donc ni déterminer la durée des requêtes lentes, ni savoir immédiatement combien d'entre elles sont concernées.
Le P95 est ici de 100 millisecondes, bien que 5 % des requêtes prennent 20 fois plus de temps. Les observations les plus lentes se situent juste au-dessus du seuil P95 choisi ; c'est le P99 qui les rend visibles dans cet exemple. Cela ne signifie pas pour autant que le P99 détecte systématiquement tous les retards significatifs.
D'autres définitions des quantiles peuvent impliquer une interpolation entre les valeurs triées et donc fournir des résultats différents. De même, un centile estimé à partir des tranches d'un histogramme ne correspond pas nécessairement à celui obtenu à partir de valeurs individuelles. Pour une interprétation correcte, il convient donc de tenir compte des méthodes de calcul, du nombre de requêtes et de la période considérée, en plus de la valeur affichée.
Interroger le P95 avec PromQL
Pour la requête suivante, tu dois disposer d'un accès à une source de données Prometheus et d'un histogramme classique existant pour les durées de requête. Saisis l'expression dans le navigateur d'expressions Prometheus ou dans un champ de requête Grafana dédié à Prometheus. Cette requête lit les séries chronologiques existantes ; il ne s'agit ni d'une commande de terminal ni d'une modification de configuration.
Le nom de la métrique est un espace réservé. Remplace-le, le cas échéant, par le nom de ton instrumentation et vérifie si les séries chronologiques sélectionnées ont des limites de bucket compatibles. L'exemple effectue une agrégation sans filtre supplémentaire sur toutes les autres étiquettes et ne fournit donc la valeur totale souhaitée que si cette sélection correspond à ta question opérationnelle.
Calculé en premier lieu rate à partir des compteurs cumulés par tranche, leur taux de variation sur une fenêtre glissante de cinq minutes. Ensuite, on additionne sum by (le) les taux des autres labels. Cet ordre permet de prendre en compte les réinitialisations des compteurs de certaines séries chronologiques lors du calcul des taux.
Le label le reste inchangé : il désigne la limite supérieure du segment correspondant. À partir de la distribution agrégée, on estime histogram_quantile le Total P95. Dans le système de mesure en secondes utilisé ici, le résultat est également exprimé en secondes ; 0,4 correspond donc à 400 millisecondes.
Pour P99, tu remplaces le premier paramètre 0.95 par 0.99. À l'aide de filtres de balises adaptés, tu peux par exemple sélectionner un service ; des balises de regroupement supplémentaires permettent d'obtenir des résultats distincts. Vérifie à chaque fois quelles requêtes sont prises en compte et si la résolution des buckets est suffisante pour le domaine qui t'intéresse.
Pour histogrammes natifs la syntaxe de requête est différente : vous n'utilisez pas la syntaxe classique séparée _bucket-Série avec le. La disponibilité des histogrammes natifs et la manière de les exporter dépendent des composants utilisés et de leurs versions.
Comparer les instances et les groupes de requêtes
Un P99 commun pour les accès en cache et les appels dynamiques permet de répondre à la question concernant le volume total des requêtes sélectionnées. Il n'explique toutefois pas quel groupe a évolué. Si la proportion d'accès rapides en cache varie, la valeur totale peut également changer sans que chaque groupe ait nécessairement ralenti.
Complète donc la valeur globale en ajoutant des vues distinctes pour les éléments pertinents sur le plan technique Groupes de demandes, à condition que des étiquettes appropriées soient disponibles. Une désignation d'itinéraire limitée ou un statut de cache peuvent s'avérer utiles à cet effet. En revanche, les URL individuelles ou les identifiants d'utilisateurs utilisés comme étiquettes peuvent générer un très grand nombre de séries chronologiques ; choisissez les dimensions de manière à ce qu'elles répondent à une question précise.
Pour obtenir un centile global sur plusieurs instances, on commence, dans le cas d'histogrammes classiques compatibles, par regrouper les compteurs de tranches ou leurs taux par limite. Ce n'est qu'à partir de cette distribution commune que le quantile est estimé. La moyenne des valeurs P99 des différentes instances ne donne généralement pas un P99 global correct, car les distributions et le nombre de requêtes peuvent varier.
| format de données | Agrégation et précision | Charge de travail liée aux données |
|---|---|---|
| histogramme | Les tranches compatibles peuvent être agrégées ; quantiles estimés, précision dépendant de la résolution et de la représentation | Séries chronologiques ou données d'histogramme en fonction de la résolution et de la combinaison d'étiquettes choisies |
| Résumé | Les quantiles calculés au cours du processus ne peuvent pas être agrégés en un quantile global ; la précision dépend de la configuration | Calcul des quantiles dans le processus et séries chronologiques pour les quantiles configurés |
| Événements ponctuels | Une analyse conjointe est possible si les valeurs individuelles pertinentes sont disponibles ; le résultat dépend de la méthode de quantile choisie. | Potentiellement un enregistrement par requête ; le stockage et l'analyse peuvent s'avérer fastidieux |
A Résumé peut s'avérer utile pour analyser un processus pris isolément. Cependant, les quantiles déjà calculés dans ce cadre ne peuvent pas être regroupés a posteriori pour obtenir un quantile correct valable pour toutes les instances. Les événements individuels permettent d'atteindre un autre niveau de détail, mais supposent que les observations nécessaires aient bien été enregistrées et soient disponibles.
Définir les objectifs de latence et les alertes
Un objectif de latence ne peut être vérifié que si la population de référence est clairement définie. L'objectif „ 95 % des requêtes sélectionnées prennent au maximum 300 millisecondes “ nécessite donc des informations sur le point de mesure, les terminaux concernés et la période d'évaluation. Une fenêtre de cinq minutes répond à une question opérationnelle différente de celle posée par une fenêtre journalière.
Pour le seuil tu divises le nombre d'observations jusqu'à 300 millisecondes inclus par le nombre total d'observations. Dans un histogramme classique, un intervalle correspondant exactement à cette limite fournit le compteur approprié ; pour une fenêtre temporelle, tu utilises les variations de compteur ou les taux correspondants. La proportion indique immédiatement si le seuil choisi a été atteint dans la fenêtre.
En l'absence d'une limite de bucket fixée à 300 millisecondes, il n'est pas possible de déterminer la proportion exacte à partir des compteurs de buckets seuls. La valeur P95 estimée peut néanmoins servir de référence, mais sa précision dépend de la distribution et des limites des buckets. Pour un seuil cible important, il est donc utile de vérifier au préalable la configuration de l'histogramme.
Précisez également clairement comment les erreurs sont prises en compte dans l'objectif. Une réponse rapide à un message d'erreur ne doit pas être considérée d'emblée comme une bonne expérience utilisateur ; selon la définition de l'objectif, les erreurs peuvent par exemple être suivies séparément ou considérées comme des événements négatifs. Il est essentiel que le numérateur et le dénominateur correspondent à la définition choisie.
A Durée de l'alarme Cela évite que chaque fluctuation mineure ne déclenche immédiatement une notification. Définissez un nombre minimum d'observations afin que quelques requêtes isolées n'influencent pas de manière disproportionnée le déclenchement d'une alerte. Ces deux valeurs doivent être adaptées au volume de trafic et au degré d'urgence du service ; les données manquantes doivent faire l'objet d'un traitement spécifique.
Dans le tableau de bord, il est utile d'afficher côte à côte le pourcentage cible, le volume de requêtes et le taux d'erreur. Cela permet de déterminer si un non-respect de l'objectif concerne un grand nombre de requêtes ou s'il est lié à une période très courte. Une alerte devrait en outre indiquer quelle sélection et quelle période ont déclenché le message.
Analyser systématiquement les centiles croissants
Si le P99 augmente, vérifie d'abord le volume des requêtes et le Combinaison de points d'arrivée. Un nombre accru de requêtes dynamiques lentes peut faire varier la valeur globale, même si la durée de chaque groupe de requêtes n'a pratiquement pas changé. À l'inverse, une diminution du nombre de requêtes rapides peut augmenter la proportion de requêtes plus lentes.
Compare ensuite les vues séparées par itinéraire et par groupe de statuts, dans la mesure où l'instrumentation fournit ces étiquettes. Un parcours particulier peut affiner la recherche ; les groupes d'erreurs distincts indiquent en outre si ce sont les réponses d'erreur rapides ou lentes qui influencent la répartition. Utilisez si possible des catégories de parcours limitées plutôt que des URL individuelles ou des identifiants d'utilisateurs.
Examine ensuite en parallèle la charge, les files d'attente, la durée d'accès à la base de données et le taux d'erreur sur la même période. Une file d'attente qui s'allonge alors que le P99 augmente en parallèle constitue un point de départ pour l'analyse, mais ne prouve pas encore qu'elle soit à l'origine du retard. Vérifie également si les indicateurs concernent le même service et des groupes de requêtes comparables.
Utile pour certaines opérations lentes Traces et des journaux sélectionnés de manière ciblée, dans la mesure où ils sont disponibles et liés au contexte de la requête. Une trace peut, par exemple, montrer quelle partie d'un chemin de requête prend beaucoup de temps. Il faut ensuite vérifier, à l'aide d'autres observations, si cette partie en est réellement la cause.
L'article consacré à ce sujet explique comment les métriques, les journaux et les traces se complètent pour répondre aux questions opérationnelles en suspens. Observabilité dans l'hébergement. Pour les files d'attente, il y a aussi le Surveillance de la file d'attente un cas d'utilisation similaire : il s'agit là de la transmission de messages, et non pas directement de la latence d'une requête HTTP.
Pour chaque comparaison, notez les plages horaires et les points de mesure concernés. Une durée d'accès à la base de données et une latence du serveur simultanément élevées peuvent justifier une analyse plus approfondie, mais la corrélation temporelle ne suffit pas à elle seule à prouver l'existence d'un lien de causalité. Des modifications du trafic ou de l'instrumentation peuvent également influencer le tableau observé.
Qualité des données et décisions opérationnelles
Lorsque le trafic est faible, P99 réagit fortement aux observations individuelles. Dix requêtes dans une fenêtre ne permettent pas une classification aussi fiable qu’un volume important de requêtes ; il convient donc d’afficher le nombre d’observations à côté du centile. Pour les alertes, un nombre minimum peut aider à tenir compte de la pertinence des données sans exclure complètement de la surveillance les services peu utilisés.
A fenêtre vide Cela signifie qu'aucune requête n'a été observée et que la latence n'est pas nulle (en millisecondes). Affichez les valeurs manquantes ou non définies dans le tableau de bord comme il se doit et déterminez séparément si l'absence de trafic constitue en soi un problème. Ainsi, un manque de données ne sera pas interprété par erreur comme une réponse particulièrement rapide.
De même, les périodes ne peuvent pas être regroupées à volonté : un P99 sur cinq minutes correspond à une fenêtre différente de celle d'un P99 journalier. La moyenne des P99 par minute ne donne généralement pas un P99 journalier. Pour l'analyse journalière, tu as besoin des données de distribution sous-jacentes agrégables sur la période souhaitée.
Le Résolution par compartiment détermine dans quelle mesure un histogramme peut représenter avec précision la limite qui nous intéresse. Des limites choisies avec plus de précision peuvent améliorer l'estimation dans la plage concernée, mais nécessitent, dans le cas des histogrammes classiques, des séries chronologiques supplémentaires et donc davantage de mémoire. Évaluez cet effort par rapport à l'intérêt que cela présente pour la décision opérationnelle concrète.
Pour l'évaluation continue, les indicateurs se complètent : la moyenne décrit la durée moyenne, les valeurs P95 et P99 mettent en évidence les segments lents, et le pourcentage de seuil répond à un objectif de latence clairement défini. Le volume de requêtes et le taux d'erreur fournissent le contexte permettant de replacer ces valeurs dans leur contexte. Aucun indicateur pris isolément ne remplace la vérification du point de mesure, de la période et de la qualité des données.
Sources et état des connaissances
État de la recherche :
Données de référence datant du 16 novembre 2026 ; les conventions OpenTelemetry issues de la branche de développement ne constituent pas une garantie pour les versions installées.
https://sre.google/workbook/monitoring/
https://prometheus.io/docs/practices/histograms/
https://github.com/open-telemetry/semantic-conventions/blob/main/docs/http/http-metrics.md
https://prometheus.io/docs/specs/native_histograms/
https://grafana.com/docs/grafana/latest/datasources/prometheus/query-editor/