Passer au contenu

Le cgroup sous Linux Contrôleur CPU contrôle la quantité de temps de calcul allouée aux services, aux conteneurs et aux processus, et permet de planifier les performances de manière ciblée. Je t'explique concrètement comment la pondération, les quotas et les bonnes pratiques s'articulent entre eux, afin que tu puisses allouer le temps CPU en toute sécurité et éviter les goulots d'étranglement.
Points centraux
- pondération versus Limite Comprendre : un partage équitable ou un plafond strict
- cgroup v2 Privilégier : une sémantique claire, une hiérarchie cohérente
- cpu.weight et cpu.max: les deux leviers de commande
- systemd Utilisation : définir des règles par service
- Suivi et Transparence: consulter les données de cpu.stat et PSI
Comprendre les cgroups : groupes de processus et objectifs
Je résume les processus dans Groupes et je gère ainsi des ressources telles que le CPU, la mémoire et les E/S au sein de hiérarchies clairement délimitées. Au lieu de jongler avec des PID individuels, j'affecte des services complets, des conteneurs ou des pools de workers à un groupe de contrôle et je définis des règles claires. J’évite ainsi qu’une tâche qui déraille ne ralentisse la machine alors que des composants importants doivent réagir rapidement. Cette approche s’avère particulièrement utile dans le contexte de l’hébergement, car de nombreux clients et services tournent sur le même matériel. Cet article offre un bon aperçu de la mise en œuvre pratique : Les cgroups et l'hébergement, qui permet de comprendre la séparation des charges.
Fonctionnement du contrôleur CPU
Le contrôleur CPU répartit temps de calcul par le biais de deux mécanismes : la pondération relative et la limitation absolue de la bande passante. La pondération signifie que les groupes se voient attribuer des parts de CPU proportionnellement les uns aux autres dès qu'une concurrence s'installe ; les valeurs les plus élevées remportent alors plus souvent des tranches de temps. Une limite par quota plafonne la consommation dans une fenêtre temporelle fixe, même en l'absence de concurrence. J’opte pour la pondération lorsque l’équité et l’utilisation dynamique des ressources sont prioritaires, et je définis des quotas lorsqu’un plafond strict doit rester immuable. La documentation du noyau explique clairement cette différence et montre comment ces deux mécanismes s’associent pour former un modèle de contrôle cohérent [1].
cgroup v1 vs. v2 : différences et fichiers
Avec cgroup v2 Je gère les règles CPU de manière plus uniforme et plus claire par rapport à l'ancienne version v1. Dans la v1, j'utilisais différents fichiers selon les contrôleurs ; dans la v2, je me concentre sur cpu.weight pour la priorité relative et sur cpu.max pour une limite de bande passante stricte. Cette séparation claire réduit le temps de configuration, évite les malentendus et facilite les audits. Dans les scénarios d'hébergement comportant de nombreux conteneurs, la hiérarchie de la v2 garantit des règles traçables à tous les niveaux. L'article consacré à cgroup v2 en hébergement, qui aborde la question de la gestion cohérente du matériel partagé.
| Sujet | cgroup v1 | cgroup v2 | Paramètres typiques |
|---|---|---|---|
| Pondération du CPU | cpu.shares | cpu.weight | cpu.weight (Valeur par défaut : souvent 100) |
| Quota/limites du processeur | cpu.cfs_quota_us + cpu.cfs_period_us | cpu.max | cpu.max (par exemple : 20 000 100 000) |
| Hiérarchie | Contrôleurs séparés | Arborescence uniforme | Règles communes à chaque niveau |
| Temps réel | Contrôleur rt séparé | Restrictions concernant la RT | Voir les notes sur le noyau [1] |
Pour les administrateurs, ce qui compte, c'est que Consistance réduire les erreurs dans la configuration et accélérer la prise en compte des modifications. Je documente les paramètres au niveau des nœuds de groupe afin que chacun puisse comprendre leur impact actuel. Lors des migrations depuis la v1, je vérifie minutieusement les équivalences, notamment les « Shares » par rapport à « Weight » et les « CFS-Quota » par rapport à « cpu.max ». Ce n’est que lorsque les charges de test réagissent comme prévu que je transfère les services de production vers la nouvelle hiérarchie. Cette transition rigoureuse permet d’économiser par la suite de nombreux cycles d’assistance.
Hiérarchie, sous-arborescences et délégation
Dans cgroup v2, je contrôle les contrôleurs par niveau et délègue-les si nécessaire. Via cgroup.subtree_control J'active le contrôleur CPU pour les nœuds enfants ; systemd s'en charge généralement automatiquement lorsque je définis les propriétés du CPU. Important : dans la v2, je conserve idéalement les processus dans Groupes de feuilles et non dans des nœuds intermédiaires. Les règles restent ainsi plus claires, et la répartition de la charge suit clairement la structure arborescente. Dans les configurations complexes, j'attribue des services entiers à des tranches (par exemple,. tenant-a.slice), notamment les services et les pools de travailleurs. Cette séparation claire facilite la délégation aux équipes qui travaillent dans „ leurs “ sous-arborescences sans enfreindre les politiques globales.
Paramètres importants : cpu.weight et cpu.max
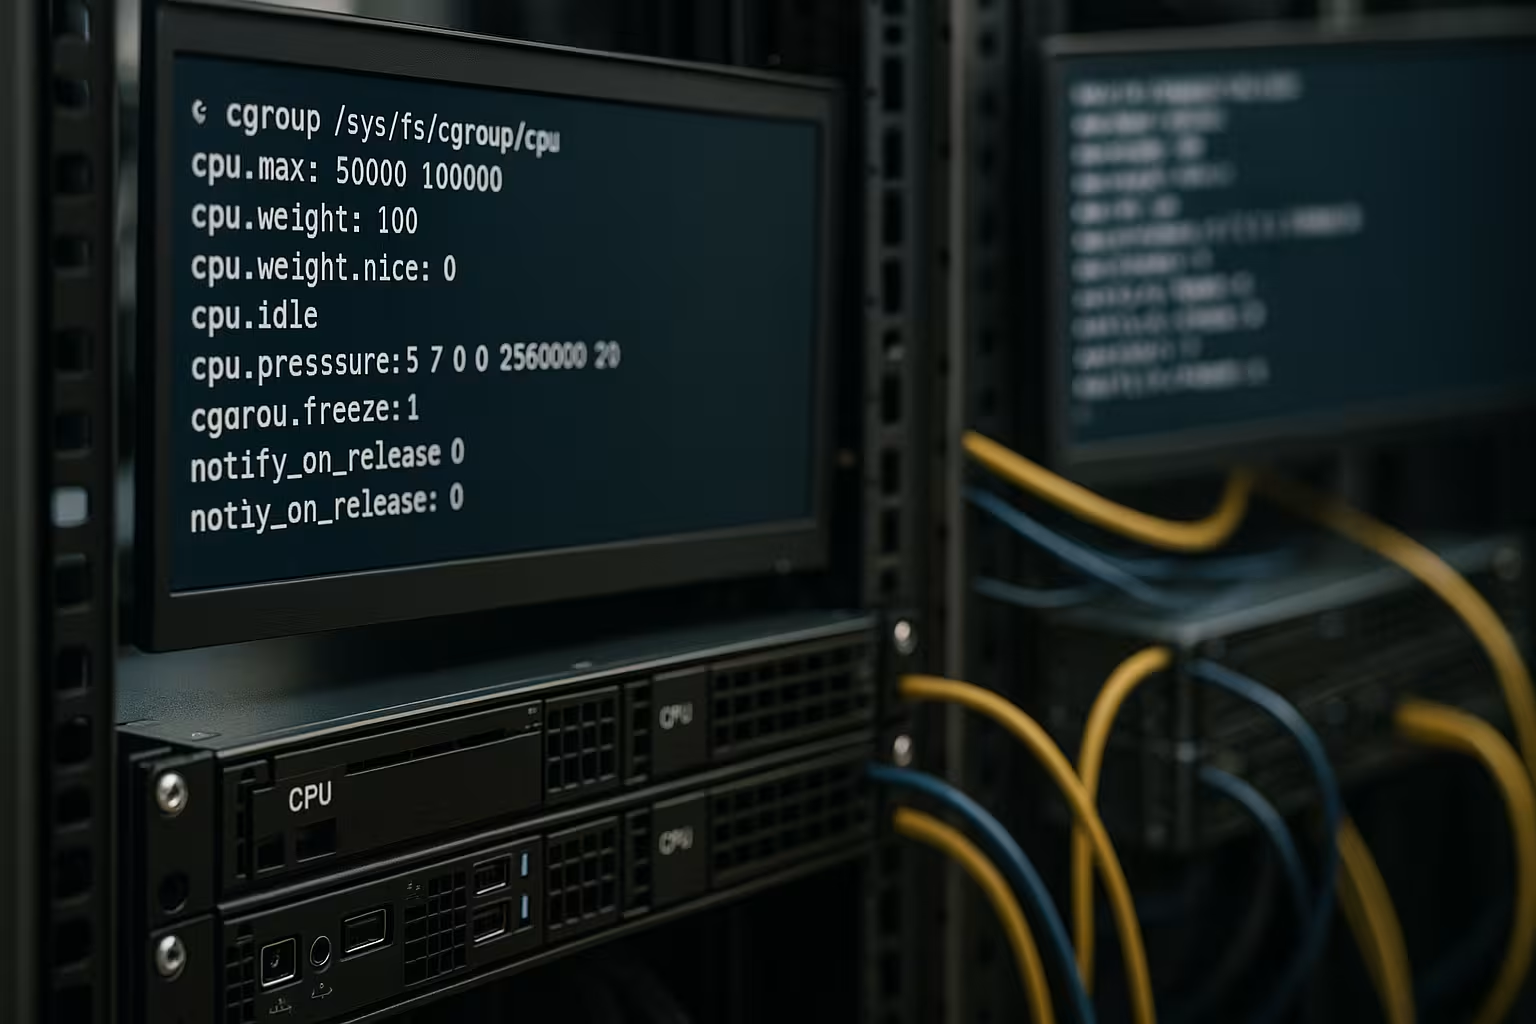
J'utilise cpu.weight, afin de hiérarchiser les services de manière relative : si le service A se voit attribuer un poids supérieur à celui du service B, A se verra attribuer plus souvent du temps CPU en cas de charge. La valeur par défaut dans la v2 est souvent de 100 ; des valeurs plus élevées favorisent le groupe concerné, mais je reste dans des fourchettes raisonnables afin de garder ce rapport sous contrôle. Pour les plafonds stricts, j’écris dans cpu.max un quota et une période, par exemple 20000 100000 pour environ 20 % d'un slot vCPU. Avec max Dans un premier temps, je supprime la limite maximale, mais je conserve la période, ce qui facilite les diagnostics. Red Hat documente de manière claire les paramètres courants et en présente les conséquences en production [2].
Paramètres supplémentaires : cpu.weight.nice et UClamp
Pour les équipes qui s'éloignent de la méthode classique sympa-En matière de sémantique, la version 2 propose cpu.weight.nice un lien pratique : je peux accompagner des groupes dans le domaine -20..19 classer, qui est converti en interne selon l'échelle de pondération. Ainsi, les attentes relatives („ privilégier un peu “, „ réduire légèrement “) restent cohérentes, sans qu'il soit nécessaire de définir à chaque fois des pondérations concrètes. De plus, si nécessaire, j'utilise Serrage par utilisation via cpu.uclamp.min et cpu.uclamp.max, afin de définir une limite minimale ou maximale pour l'utilisation effective du processeur au niveau du planificateur. Cela me permet, par exemple, de m'assurer qu'un service sensible à la latence ne tombe pas en dessous de l'utilisation de base requise, même avec un faible nombre de threads, ou que les tâches par lots ne bénéficient pas d'un boost trop important. Ce réglage fin complète la pondération et les quotas, mais ne les remplace pas : je vérifie toujours la compatibilité d’UClamp avec ma politique de gestion des charges et d’énergie avant de le déployer à grande échelle.
Planification des charges de travail : équité ou limites strictes ?
Je décide en connaissance de cause si Équité ou que les limites maximales strictes aient la priorité. Pour les services Web où la latence est critique, j’augmente légèrement leur pondération afin qu’ils soient exécutés en priorité en cas de concurrence, sans pour autant pénaliser excessivement les autres groupes. Pour les tâches batch gourmandes en ressources, je fixe en outre un quota afin qu’elles ne prennent jamais trop de temps, même si le système est par ailleurs inactif. Je conserve une pondération modérée pour les bases de données et j’observe l’impact des points de contrôle, des reconstructions ou des requêtes volumineuses ; si nécessaire, j’effectue des ajustements temporaires. Je combine ces règles avec des alertes afin de pouvoir réagir rapidement avant que les latences ne s’aggravent.
Comportement des quotas sur les processeurs multicœurs et choix de la période
L'interprétation de… constitue souvent une source de difficultés. Performances sur les systèmes multicœurs. Un taux se rapporte à la Temps de calcul total du groupe par période, et non sur des cœurs individuels. CPUQuota=200% ou cpu.max = 200 000 100 000 Cela correspond en gros à deux secondes CPU par période de 100 ms, réparties entre tous les threads/cœurs. Cela peut signifier que de nombreux threads s'exécutent en parallèle pendant un court instant, jusqu'à ce que le groupe soit „ épuisé “ au cours de la période en cours et soit alors limité. J'évite les malentendus en concevant toujours les quotas en termes de „ créneaux CPU “ et en les adaptant au degré de parallélisme du service.
La période standard est souvent de 100 ms. Périodes plus courtes (z. B. (50 ms) permettent une mise en œuvre plus rapide de la limitation, mais peuvent générer des micro-fluctuations ; des périodes plus longues lissent le signal, mais réagissent plus lentement. Sous systemd, je règle cela avec CPUQuotaPeriodSec= et je vérifie si les pics de latence ou les objectifs de débit sont mieux respectés. Pour les services interactifs, je mesure la latence de bout en bout ; pour les traitements par lots, je me base sur le débit global et l'équité vis-à-vis des voisins.
Pratique : configuration avec systemd et cgroup v2
Avec systemd, je définis des règles pour chaque service, car Fichiers de service permettre une configuration reproductible. Avec systemctl set-property Je les modifie régulièrement, et j'utilise des fichiers « drop-in » pour gérer proprement les versions des paramètres. Un exemple : systemctl set-property --runtime nginx.service CPUWeight=150 NGINX effectue une légère priorisation ; systemctl set-property --runtime batch.service CPUQuota=20% limite les tâches par lots. Je note systématiquement dans /etc/systemd/system/service.d/limits.conf activez les options correspondantes et rechargez les unités. Pour vous lancer facilement, nous vous recommandons de consulter ce guide sur Contrôle des ressources systemd, qui résume brièvement les options les plus courantes.
# Exemples pour systemd v245+ avec cgroup v2
# Priorisation relative
systemctl set-property --runtime nginx.service CPUWeight=150

# Limite maximale stricte
systemctl set-property --runtime batch.service CPUQuota=20%

# Combinaison dans un fichier ' drop-in '
mkdir -p /etc/systemd/system/php-fpm.service.d
cat < /etc/systemd/system/php-fpm.service.d/cpu.conf
[Service]
CPUWeight=120
CPUQuota=50%
EOF
systemctl daemon-reload
systemctl restart php-fpm.service
Slices pour les locataires et les équipes
Pour les limites des clients ou des équipes, j'utilise Tranches comme structure organisationnelle. Une « slice » regroupe plusieurs services et périmètres, qui sont réglementés ensemble. Cela me permet d'attribuer des budgets par client sans avoir à gérer chaque unité individuellement, et de déléguer les modifications de manière contrôlée.
# Tenant-Slice avec règles par défaut
mkdir -p /etc/systemd/system/tenant-a.slice.d
cat < /etc/systemd/system/tenant-a.slice.d/cpu.conf
[Slice]
CPUWeight=120
CPUQuota=150%
# Facultatif : période pour une limitation plus fine
CPUQuotaPeriodSec=100ms
EOF
systemctl daemon-reload
systemctl restart tenant-a.slice
Tous les services sur tenant-a.slice héritent de ces paramètres. En cas de pics de courte durée, j'augmente temporairement la pondération, mais je maintiens le taux stable afin de ne pas évincer les systèmes voisins.
Surveillance et dépannage
J'évalue l'efficacité et les effets secondaires à l'aide de Transparence en métriques. Les fichiers cpu.stat et cpu.pressure (PSI) par cgroup me fournit des ratios, des temps d'attente et des engorgements qui indiquent un ralentissement ou une surcharge. Avec top, htop et systemd-cgtop Je repère en temps réel les tendances de répartition et je les compare à mes règles. Lorsque les latences augmentent alors que le processeur est inactif, le problème provient plutôt des E/S ou des verrous que des limites du processeur ; je ne modifie donc pas la pondération à la hâte. Après chaque modification, je documente les valeurs mesurées sur au moins un cycle de charge afin d’éviter toute corrélation erronée.
Guide pratique du suivi : ce que je lis concrètement
cpu.stat: usage_usec, user_usec, system_usec indiquent la consommation ; nr_periods, nr_throttled, throttled_usec révèlent une forte réduction. Augmente nr_throttled/nr_periods Si l'écart dépasse quelques pour cent, c'est que l'intervalle est trop étroit ou la période trop courte.cpu.pressure: J'observe some avg10/60/300 pour les bouchons ayant une incidence sur la latence. Une valeur élevée persistante malgré des processeurs inactifs indique une contention sur les verrous, des conflits d'affinité ou des accès NUMA à distance.systemd-cgtopetps: Je vérifie si les threads peuvent réellement fonctionner en parallèle ou s'ils attendent des ressources exclusives.
Pour des tests reproductibles, j'utilise stress-ng, sysbench ou j'utilise mes propres générateurs de charge et je réalise des instantanés des métriques avant et après. Ce n'est que lorsque les valeurs mesurées correspondent de manière stable aux prévisions que je déploie les modifications.
Temps réel et particularités
À l'adresse suivante : Temps réel- En ce qui concerne les charges de travail, je suis les consignes de la documentation du noyau, car la version 2 ne gère le contrôleur CPU pour le temps réel que de manière limitée. Certains threads en temps réel doivent se trouver dans le cgroup racine, et la configuration nécessite une approche prudente. Je vérifie également la compatibilité de l’ordonnancement RT avec les quotas, afin d’éviter tout dépassement involontaire d’une échéance. Pour les services Web et de bases de données classiques, j’utilise des politiques normales, car cette configuration reste plus prévisible au quotidien. Lorsque j’ai besoin de RT, je sépare clairement les systèmes ou je réserve des cœurs afin d’éviter toute interaction inattendue [1].
Contrôle de précision sur les systèmes multicœurs
Le contrôleur CPU répartit Créneau horaire, et non la fréquence d'horloge ; c'est pourquoi je l'associe, si nécessaire, à cpuset et à l'affinité. Pour obtenir une latence faible, je limite les changements entre sockets, j’affecte les threads aux cœurs locaux NUMA et j’optimise la répartition des IRQ. Je laisse les services par lots s’exécuter de manière plus flexible afin qu’ils exploitent la capacité restante sans bloquer les cœurs destinés aux front-ends critiques. Je vérifie les politiques Turbo ou d’économie d’énergie, car les variations de fréquence peuvent fortement modifier le comportement sous charge. Seule la combinaison des quotas, des pondérations, de l’affinité CPU et de la stratégie énergétique permet d’obtenir des résultats cohérents.
SMT, NUMA et affinité dans la pratique
Sur les systèmes équipés de SMT/hyper-threading Je constate que deux threads logiques sur un cœur physique ne correspondent pas à deux slots CPU complets. Un quota de „ 100 % “ correspond à un slot logique, et pas nécessairement à la pleine puissance d'un cœur physique. Je mesure donc la latence et le débit avec et sans utilisation de la technologie SMT. Sur les systèmes NUMA, je limite les services critiques à l’aide de AllowedCPUs= (cpuset) ou CPUAffinity= sur les cœurs locaux et configurez la liaison mémoire en conséquence, afin que les accès à distance ne compromettent pas toute la planification détaillée.
Bonnes pratiques en matière d'hébergement et de conteneurs
Je commence avec des taux modérés Défauts: Donner un peu plus de poids aux services Web, les bases de données sont proches des valeurs par défaut, le traitement par lots est soumis à un quota. Pour les locataires, je définis des plafonds par client et j'autorise les pics de charge grâce à la pondération, tant qu'il n'y a pas d'autres besoins. Je documente les profils par cas d’utilisation, par exemple „ latence critique “, „ mixte “ et „ charge de calcul importante “, et je définis pour chaque profil des plages claires pour weight et cpu.max. Je déploie d’abord les modifications en environnement de staging et je les teste avec une charge synthétique qui reproduit de manière réaliste les pics. Je conserve les journaux et les métriques au plus près des limites des cgroups afin que les diagnostics ne se perdent pas dans le flou.
Orchestration des conteneurs : parts, requêtes et limites
Dans les environnements de conteneurs, je cartographie Requêtes sur la pondération relative et Limites des quotas stricts. Cela permet des pics de charge tant que les nœuds disposent d'une capacité disponible, et garantit une répartition équitable en fonction du poids en cas de concurrence. Les pods ou services critiques se voient attribuer un poids légèrement supérieur, sans que ces limites n'entravent le fonctionnement des autres. Je veille à ce que la somme des limites par nœud corresponde de manière réaliste à la capacité CPU disponible ; sinon, malgré des règles claires, cela entraîne un ralentissement à l'échelle du système qui affecte tous les locataires.
Exemples de configurations et d'exercices de calcul
Je convertis toujours les cotes en Parts par emplacement vCPU : cpu.max = PÉRIODE DE QUOTA correspond à QUOTA/PÉRIODE de la fente. Exemple : 20000 100000 correspondent à 0,2 d'un processeur individuel ; sur quatre processeurs, cela représente au maximum 0,8 d'emplacement total, mais la répartition n'est pas garantie. Pour les pourcentages sous systemd, j'écris CPUQuota=20%, ce qui, selon la version, s'accorde avec cpu.max. Si l'on fixe des limites strictes, il faut évaluer le comportement en rafale par rapport à la latence : une période trop courte peut générer des micro-saccades, tandis qu'une période trop longue assure une répartition plus fluide, mais entraîne une réponse plus lente. Je teste donc des périodes comprises entre 50 et 100 ms et je choisis la variante qui correspond à la classe de latence du service [2].
Migration de la version 1 à la version 2 sans mauvaise surprise
Lors du changement de ligne, je passe par cpu.shares dans cpu.weight et cpu.cfs_quota_us/period_us dans cpu.max. Voici une mise en correspondance pragmatique pour les « shares » : 1024 → ~100, 2048 → ~200, 512 → ~50. J'effectue des ajustements précis après les tests de charge, car les échelles diffèrent. Je prévois également que les règles de la v2 pour les enfants cumulatif Effet : un quota restrictif au niveau du nœud parent limite l'ensemble des sous-groupes. C'est pourquoi je supprime souvent les quotas parentaux (max) et j'ajuste les paramètres de manière très précise au niveau des calques afin d'éviter les effets indésirables.
Problèmes courants et solutions
- 100 % confondu avec „ tous les cœurs “ : 100 % correspondent à un emplacement logique de CPU, et non à la machine dans son ensemble. Solution : calculer le quota en fonction du nombre d'emplacements nécessaires (par exemple, 400 % pour quatre emplacements).
- Période trop courte : Légers à-coups lors de l'utilisation de services interactifs. Solution : augmenter la période ou utiliser la pondération plutôt que le quota.
- Pondération mesurée sans concurrence : Le poids ne produit ses effets qu'en situation de concurrence. Solution : effectuer des essais avec une charge parallèle réelle.
- Oublier les quotas parentaux : Un parent limité freine tous ses enfants. Solution :
cpu.max=maxsur l'élément parent, des limites sur les feuilles. - NUMA/socket ignoré : Latence malgré un processeur inoccupé. Solution : vérifier l'affinité/les CPUSets et la localité mémoire.
Résumé
Avec le contrôleur CPU J'attribue le temps de calcul de manière ciblée, je définis des priorités équitables et je fixe des limites strictes là où cela s'avère nécessaire. cgroup v2 propose à cet effet des paramètres clairs, tels que cpu.weight et cpu.max, que je planifie et mesure en fonction de la charge de travail. Via systemd, je définis des règles par service, je vérifie leur efficacité à l’aide de cpu.stat et de PSI, puis j’ajuste les paramètres sans me livrer à des conjectures. Pour les locataires, les conteneurs et les environnements de serveurs mixtes, ce contrôle reste essentiel pour garantir la fiabilité et la prévisibilité. En documentant les règles, en les mettant en place progressivement et en les validant par des tests de charge, on évite les goulots d’étranglement et on garde le contrôle sur le temps CPU.