 Passer au contenu

Je vais te montrer comment interpréter vmstat sous Linux de manière ciblée : tu pourras identifier en quelques secondes les goulots d'étranglement du processeur, la pression sur la mémoire, l'espace d'échange et les temps d'attente d'E/S. Voici comment interpréter en toute confiance les colonnes r, b, free, si/so, bi/bo et us/sy/id/wa/st, et comment déduire des mesures concrètes à partir des tendances observées – sans avoir à deviner, grâce à clair Règles.
Points centraux
- File d'attente d'exécution vs. blocages : « r » indique la charge du processeur, « b » signale les temps d'attente liés aux E/S.
- Mémoire Évaluer la situation réelle : la gratuité ne suffit pas à elle seule, c'est « si/alors » qui fait la différence.
- E/S À surveiller : les indicateurs bi/bo ne sont pas préoccupants tant que wa reste faible.
- Parts de marché des processeurs Interprétation : us+sy élevés, id faible → charge élevée.
- Bases Établir : comparer les valeurs au quotidien avec celles observées lors de périodes difficiles.
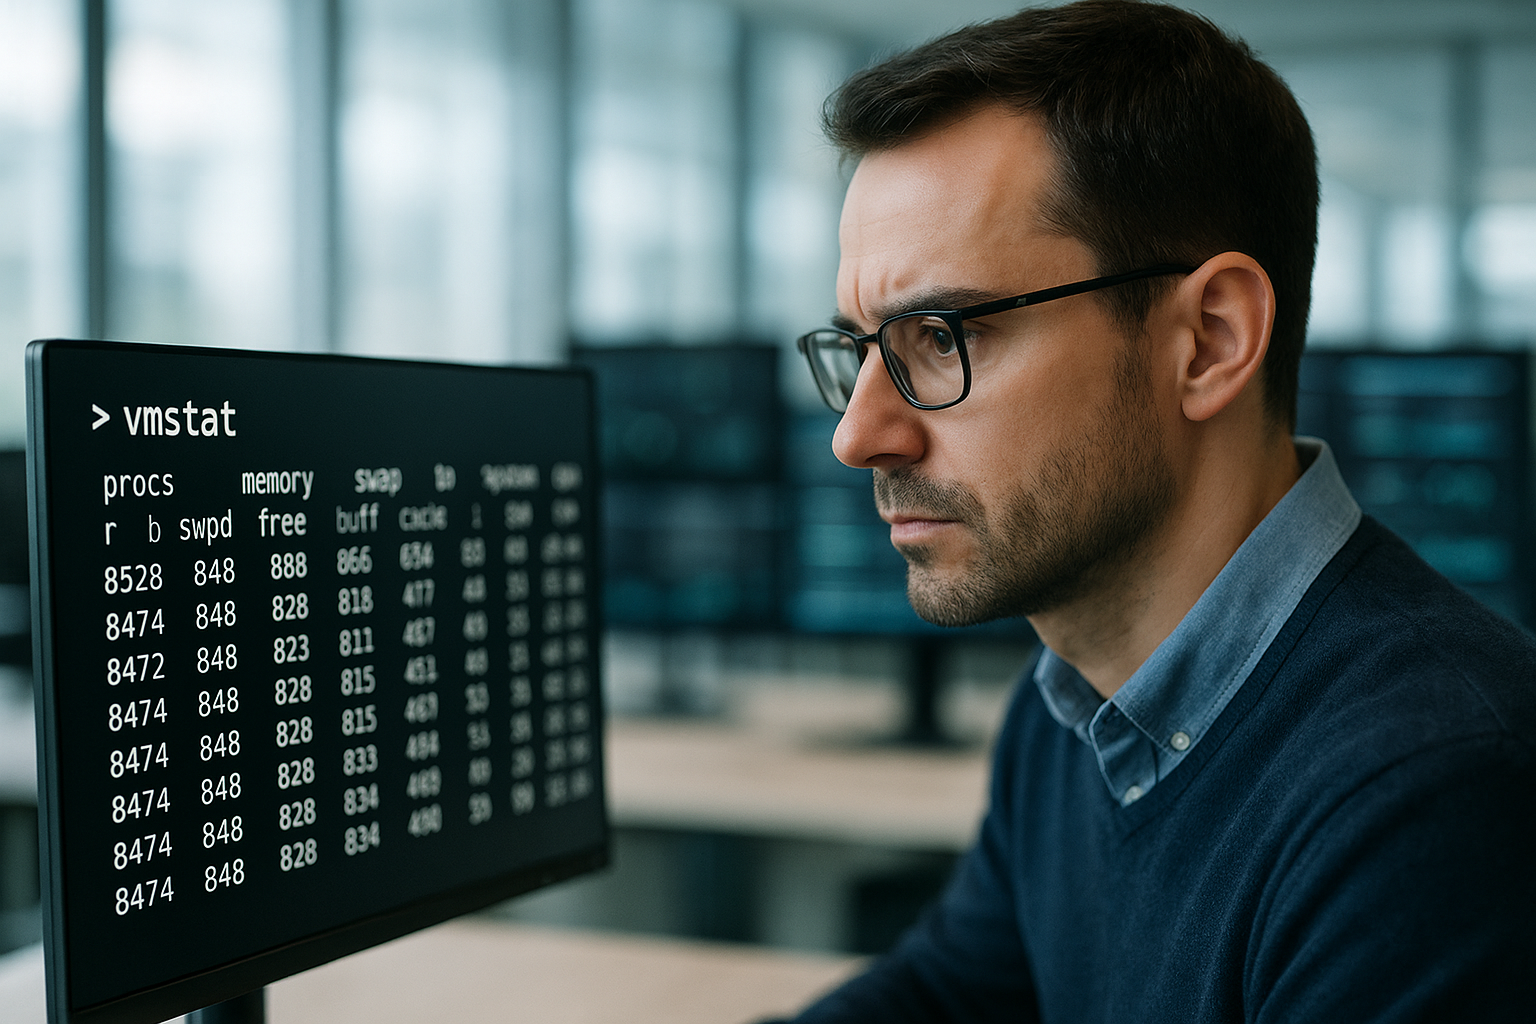
Que montre réellement vmstat ?
Vmstat regroupe les états des processus, la mémoire, l'espace d'échange, les E/S par blocs et les parts d'utilisation du processeur dans un résultat concis qui fournit en quelques secondes un à l'échelle du système Cela donne une bonne idée de la situation. Je commence par lire „ procs “ pour r/b, puis „ memory/swap “ pour free, buff, cache ainsi que si/so. Ensuite, je vérifie „ io “ avec bi/bo et je termine par „ cpu “ pour us, sy, id, wa et, éventuellement, st. Cet ordre m’aide à distinguer la cause de l’effet : une valeur élevée de r indique une charge de calcul importante, une valeur élevée de b signale des temps d’attente en E/S, tandis que wa relie l’inactivité du processeur à la latence en E/S. Je peux ainsi déterminer si le frein est le travail de calcul, un manque de mémoire ou le support de stockage – et je m'épargne Détours.
Début dans 60 secondes : appels et intervalles
Pour obtenir un instantané depuis le démarrage, je lance „ vmstat “ sans paramètre ; pour des analyses en temps réel, j'utilise „ vmstat 1 “ ou „ vmstat 5 12 “ pour obtenir douze points de mesure toutes les cinq secondes, ce qui me donne un temporelle Ligne. Important : la première ligne reflète les valeurs moyennes depuis le démarrage du système ; je me concentre donc principalement sur les lignes suivantes. Avec Delay/Count, je contrôle la fréquence d’échantillonnage et la durée, par exemple „ vmstat 1 30 “ pour les pics de courte durée. Pour les charges de travail irrégulières, je règle ce paramètre sur 1 à 2 secondes, tandis que pour les scénarios calmes, je préfère 5 secondes. J’observe les tendances, et non des images isolées, car ce sont les schémas qui révèlent les véritables Causes montrer.
Comprendre les processus : r et b au quotidien
La colonne « r » indique le nombre de threads prêts à s'exécuter qui attendent du temps CPU, tandis que la colonne « b » compte les threads bloqués, souvent en attente d'E/S. Si la valeur de « r » reste nettement supérieure au nombre de cœurs physiques, cela soulève une goulot d'étranglement du processeur ; sur quatre cœurs, une valeur r = 8 maintenue pendant un certain temps est considérée comme un signal clair. Une valeur b supérieure à 0 maintenue pendant un certain temps indique des supports de données lents, des bases de données surchargées ou des chemins réseau ou de stockage lents. Je corrèle r avec us+sy et id : si id est faible et r élevé, le processeur est sous pression ; si wa est élevé et b élevé, ce sont les E/S qui ralentissent le système. C’est ainsi que je décide s’il faut augmenter la puissance de calcul, optimiser les requêtes ou Système de stockage vérifie.
Interpréter les variables de mémoire : free, buff, cache, swpd
Une valeur « free » faible est normale sous Linux, car le noyau utilise intensivement la mémoire vive comme cache, ce qui accélère les accès aux fichiers et offre un véritable Débit . Je prête donc davantage attention à swpd et aux flux de swap si/so qu'à la seule valeur free. Un cache élevé est une bonne chose tant que si/so reste presque toujours à 0 ; seule une activité de swap persistante indique une réelle pression. Si une latence supplémentaire ou même un OOM survient, j’interviens : j’augmente la RAM, je réduis les processus à temps ou j’ajuste la taille du cache et de la JVM. Le contexte reste important : la charge de travail, la taille de la mémoire et la disposition NUMA déterminent ce qui, dans votre environnement, est considéré comme en bonne santé s'applique.
Activité de swap : la classer d'une manière ou d'une autre
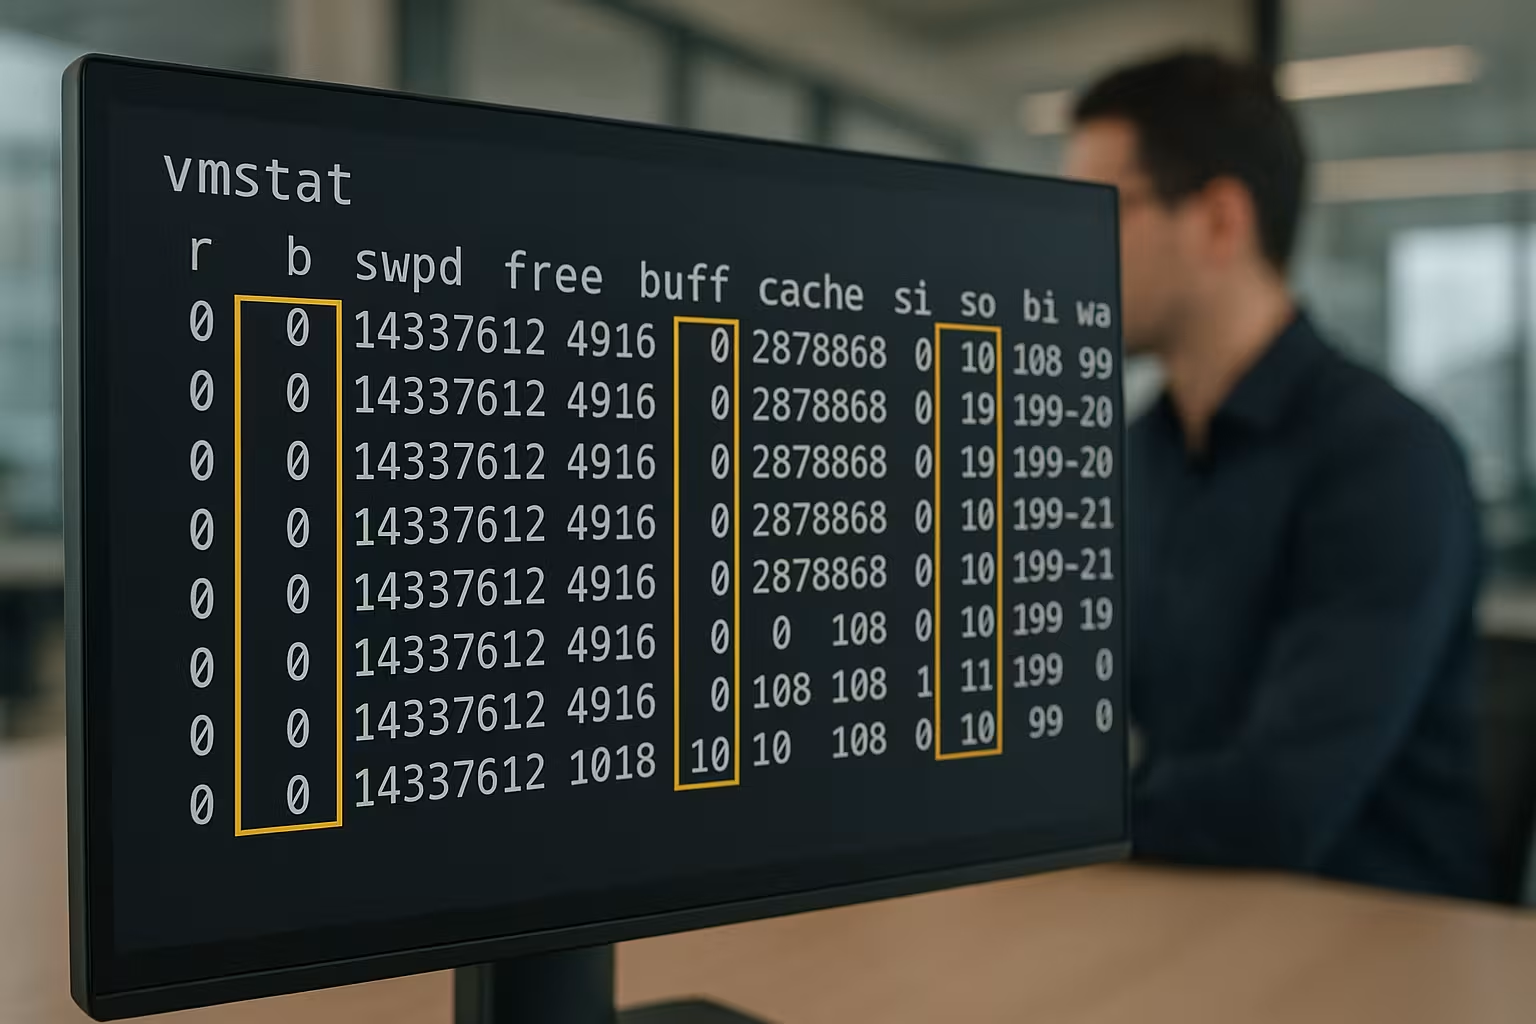
Les colonnes « si » et « so » mesurent le flux constant entre la RAM et l'espace d'échange en Ko/s et mettent en évidence la pression réelle sur la mémoire, et pas seulement celle qui est perçue carence. De brèves pointes sont normales, par exemple lorsque des pages rarement utilisées sont déplacées. La situation devient critique lorsque ces valeurs restent durablement supérieures à 0 ; cela ralentit l'ensemble du système, car chaque opération de pagination génère des coûts d'E/S supplémentaires. Des valeurs élevées de « so » indiquent une pagination active, et les temps de réponse augmentent de manière significative. À ce stade, j'interviens pour remédier aux causes : réduire la consommation de mémoire, augmenter la RAM ou optimiser les services gourmands en mémoire. tunen.
Comprendre les E/S par blocs : bi et bo
Avec bi/bo, je peux déterminer le débit de lecture et d'écriture en blocs par seconde, mais sans contexte, je ne l'évalue pas ; ce qui est déterminant, c'est l'interaction avec wa. Des valeurs bi/bo élevées associées à une valeur wa élevée indiquent que le stockage ne suit pas. Si une valeur bi élevée est associée à une base de données, je vérifie les profils de requêtes et les coups de cache avant de remplacer le matériel. Pour une analyse plus approfondie des temps de réponse, j’utilise iostat et j’analyse la longueur des files d’attente et les latences, ce qui me permet de Analyser l'attente d'E/S et de remédier de manière ciblée aux goulots d'étranglement. Ce n'est que lorsque wa reste faible, mais que bi/bo explose durablement, que j'envisage de Mise à l'échelle du système de stockage.
Parts du processeur : us, sy, id, wa, st
Des valeurs us élevées associées à une valeur wa faible indiquent un travail utile productif, tandis que des valeurs sy élevées suggèrent une surcharge importante du noyau, due par exemple à d'innombrables petites opérations d'E/S ou à un grand nombre de Changement de contexte. Si id est proche de 0 et y reste, le processeur fonctionne à pleine capacité ; combiné à une valeur élevée de r, cela indique une charge de calcul importante. Si wa augmente, le processeur attend une opération d’E/S – dans ce cas, l’optimisation du stockage apporte souvent plus que des mises à niveau du processeur. Dans les machines virtuelles, je surveille st (steal) : des valeurs st élevées indiquent que l’hyperviseur détourne du temps CPU, ce qui m’amène à discuter de la charge de l’hôte avec l’opérateur. J’évalue toujours us+sy comme une somme, car celle-ci reflète l’activité Travail dans le système.
Guide rapide : colonnes et valeurs indicatives
J'utilise le tableau suivant comme aide-mémoire succinct lorsque j'analyse les résultats de vmstat pour une première Estimation lecture en diagonale.
| Colonne | Signification | Ce à quoi je fais attention |
|---|---|---|
| r | Threads en cours d'exécution | Permanent > Noyaux → Pression du processeur |
| b | Fils de discussion bloqués | Constante > 0 + wa élevé → problème d'E/S |
| free | RAM libre | Une valeur faible ne pose pas de problème tant que si/so reste ≈ 0 |
| mémoire tampon/cache | Mémoire tampon FS/Cache de pages | Une mémoire cache importante, c'est bien ; peut être partagé seront |
| si/so | Swap In/Out | Valeur permanente > 0 → pression réelle dans le réservoir |
| bi/bo | E/S par blocs | Critique uniquement si wa est élevé en même temps |
| us/sy | Utilisateur/Noyau | us+sy en continu > 80% → élevé Dernier |
| id | ralenti | Près de 0 au fil du temps → CPU saturé |
| wa | Attente E/S | Haut avec b haut → Le stockage en cause |
| st | Vol (machines virtuelles) | Élevé → L'hyperviseur utilise CPU-Heure |
Références et suivi continu
Je ne me fie pas à des instantanés isolés, mais je compare ces valeurs à des références issues de périodes calmes, afin d'éliminer proprement les valeurs aberrantes reconnais. „ vmstat 1 60 “ me fournit un profil de charge sur une minute, que je compare aux phases normales connues. Pour avoir une vue d'ensemble historique, j'utilise Surveillance sar/sysstat, afin d'analyser les tendances sur plusieurs jours et d'affiner les seuils. Je définis les alertes de manière prudente : r par rapport aux valeurs de référence, si/so différent de 0 sur plusieurs intervalles, wa sensiblement accru. Cela me permet de réagir rapidement, avant que les utilisateurs ne signalent des ralentissements et avant que Peak- Les phases s'intensifient.
Vmstat associé à d'autres outils
Je commence par vmstat, j'analyse les tendances et j'approfondis de manière ciblée avec iostat, mpstat, pidstat ou des métriques d'application, afin d'identifier les causes clairement attribue. vmstat affiche les temps d'attente d'E/S, tandis que j'utilise iostat pour mesurer les latences et les files d'attente par périphérique. Si « r » indique une limite du noyau, mpstat met en évidence les asymétries du noyau. En cas de pic de charge des processus, cela fournit Analyse des processus pidstat les fils de discussion les plus animés sur le sujet. Ce n'est qu'en établissant une corrélation avec les journaux et les temps d'exécution des applications que le tableau se précise et que j'arrive à la véritable Cause.
Identifier les schémas et agir en conséquence
Si je constate que « r » est élevé, « id » faible et « wa » modéré, l'application optimise souvent de manière trop gourmande en ressources de calcul ; c'est pourquoi je vérifie le code ou le parallélisme et je planifie les ressources CPU avant de Matériel informatique exige. Si b, wa et bi/bo sont élevés simultanément, j'envisage un réglage du stockage, une optimisation des requêtes et la mise en cache. En cas de faible valeur de free avec si/so supérieur à 0, je réduis la consommation de mémoire, je diffuse les résultats en continu ou j'augmente la RAM. Si « us » est modéré et « sy » très élevé, je me penche sur les filtres de paquets, les options du système de fichiers ou les pilotes. Grâce à cette liste de contrôle, j’agis rapidement et je consacre mon temps là où cela compte le plus compte.
Éviter les erreurs de mesure : échantillonnage, unités, première ligne
Je ne tiens délibérément pas compte de la première ligne pour les dysfonctionnements aigus, car elle effectue un lissage depuis le démarrage et élimine complètement les pics. De plus, j’adapte la fréquence d’échantillonnage à l’hypothèse de cause : je détecte les pics d’utilisation du processeur à des intervalles d’une seconde, et les fuites de mémoire lentes à des intervalles de 5 à 10 secondes. Je tiens compte des unités : si/so correspondent à Ko/s, bi/bo à „ blocs/s “ (historiquement 1 Ko par bloc, variable selon la version de vmstat). Je vérifie si la commande „ vmstat -w “ (sortie étendue) évite les coupures de colonnes et si les changements de fréquence d’horloge (états P, Turbo) influencent la perception de la charge à court terme. Je synchronise les mesures avec les pics d’activité des applications, plutôt que de considérer aveuglément des „ minutes entières “.
Décrypter la section « System » : in et cs
Outre procs/memory/swap/io/cpu, vmstat affiche également „ system “ : dans (interruptions/s) et cs (Changements de contexte/s). Ces deux valeurs m'en disent long sur la charge du noyau.
- cs très élevé pour une charge utile modérée : instabilité des threads, lots de workers trop petits ou contention sur les verrous. J'augmente la taille des lots, je régule le parallélisme (pools de threads) et je vérifie les points sensibles au niveau du planificateur et des mutex.
- en forte hausse : tempêtes d'interruptions réseau ou de stockage, effets NAPI/polling ou interruptions de temporisateur. Je compare ces données avec la part sy et les résultats d'iostat pour vérifier les pilotes ou les chemins réseau.
- cs proportionnel à r : cela indique une pression constante liée aux changements de contexte due à un parallélisme excessif. Je réduis le parallélisme actif ou j'affecte les Hot-Threads à des cœurs.
Je mets toujours en corrélation in/cs avec sy et b/wa : ce n'est qu'en les combinant que l'on obtient une image claire permettant de déterminer si le travail du noyau est utile (par exemple, le débit) ou s'il s'agit d'une simple surcharge.
Variantes et options utiles de vmstat
J'utilise vmstat de manière flexible pour obtenir des informations supplémentaires sans avoir à changer d'outil :
- vmstat -s: Compteurs cumulatifs (par exemple, processus lancés depuis le démarrage du système, erreurs de page majeures/mineures). Idéal pour comparer les fuites ou les nombres de cas sur des plages de temps données.
- vmstat -m: Utilisation de Slab – permet de classer les caches du noyau (Dentry/Inode, réseau) parmi les consommateurs de mémoire vive.
- vmstat -d: Événements liés au disque au niveau des totaux. Cela ne remplace pas iostat, mais c'est utile pour une vérification rapide de la situation réelle.
- vmstat -S M: Changer les unités (M/K) pour faciliter la lecture des chiffres.
- vmstat -w: Des colonnes plus larges permettent d'éviter que les chiffres ne soient coupés dans les longues séries de chiffres.
Je combine ces différentes options à intervalles réguliers afin de ne manquer aucun événement tout en gardant une vue d'ensemble.
Conteneurs, machines virtuelles et cgroups : particularités
Dans les conteneurs, j'interprète vmstat avec prudence : de nombreuses données du noyau s'appliquent à l'ensemble de l'hôte, tandis que les limites proviennent des Cgroups. Des valeurs r élevées dans un conteneur reflètent la perspective de l'espace de noms, mais le temps CPU réel peut être limité par les quotas CPU ou les parts CPU. Je me réfère à st (Steal) dans les machines virtuelles : un st élevé signifie que l'hyperviseur me prive de temps – dans ce cas, même une optimisation parfaite de l'application ne sert pas à grand-chose tant que l'hôte est surchargé. En cas de limites de mémoire dans les Cgroups, le si/so peut ne pas se déclencher, même si le conteneur „ s'agite “ à la limite (OOM-Kills au lieu du swap). Je vérifie donc en plus les journaux OOM et les statistiques des Cgroups, et je compare les images vmstat avec les limites.
NUMA et affinité : quand la proximité fait la différence
Sur les hôtes NUMA, je vérifie les valeurs r et us/sy par cœur (avec mpstat) et j'observe si certains sockets „ s'échauffent “ tandis que d'autres restent inactifs. Une localisation mémoire inadaptée entraîne une augmentation des valeurs cs/sy et b/wa due à des accès mémoire distants. Je teste l’affinité CPU et mémoire (cpuset, numactl), je configure les grands tas en „ interleaved “ ou en mode strictement local, et je veille à ce que les threads « chauds » s’exécutent là où se trouve leur empreinte de données. Une configuration NUMA stable lisse les valeurs cs, réduit les pics de wa et augmente la Planification en charge.
Éviter les malentendus : „ wa “ et « b » ne se résument pas à de simples « supports de données lents »
La valeur wa n'augmente pas uniquement en cas de latences de disque classiques : le réseau NFS/à forte latence, le stockage d'objets saturé, les volumes cloud bloquants ou les réécritures lentes dans le cache de page font également grimper la valeur wa. b compte les tâches en veille ininterruptible (état D) – ce qui inclut également les blocages au niveau des pilotes, des chemins réseau ou des verrous du système de fichiers. C’est pourquoi je n’évalue jamais wa/b de manière isolée, mais toujours en conjonction avec bi/bo et les temps d’exécution des applications. Si wa est élevé, mais que bi/bo est faible, cela indique souvent une Dépendance vis-à-vis de l'attente au-delà de la simple question du débit des appareils (par exemple, verrouillage, E/S déportées, congestion de la réécriture).
Optimisation avec discernement : Swappiness, Writeback, Scheduler
Je ne modifie Kernel-Tuner qu’après avoir effectué des mesures et mis en place un plan de restauration :
- vm.swappiness: Une valeur faible limite le swap proactif, ce qui est bénéfique pour les applications sensibles à la latence ; une valeur trop faible peut augmenter la pression sur le cache de pages.
- vm.dirty_background_ratio / vm.dirty_ratio (ou *_bytes) : influence les moments de réécriture. Des valeurs trop élevées entraînent de longues rafales d'écriture (pics de wa), tandis que des valeurs trop faibles augmentent le nombre de petits vidages constants (sy/bo augmentent).
- Planificateur d'E/S / Profondeur de la file d'attente: Des réglages Optima différents sur NVMe que sur HDD/RAID. Je mesure les compromis entre latence et débit avec iostat avant d'apporter des modifications.
- Chemins réseau: De nombreux petits paquets/interruptions arrivent dans /cs/sy. Les principaux leviers de réglage sont GRO/LRO, RPS/RFS et l'affinité IRQ – je fais des mesures avant et après.
Mon objectif est d'obtenir des courbes stables et prévisibles dans vmstat : des valeurs us/sy plus stables, des valeurs wa/b plus faibles, et des valeurs si/so proches de 0. Ce n'est qu'alors que je procède à la mise à l'échelle du matériel.
Guide pratique : analyse en 3 minutes avec vmstat
- 0:00–0:30 – „ vmstat 1 30 “ : ignorer la première ligne, puis examiner les colonnes r/b, us/sy/id/wa. Question : limite CPU (r élevée, id faible) ou limite E/S (b/wa élevées) ?
- 0 h 30 – 1 h 00 – État du réservoir : vérifier swpd et si/so. si/so constamment > 0 ? → pression réelle du réservoir. free n'a pas d'importance.
- 1 h 00 – 1 h 30 – Contexte E/S : bi/bo vs wa. Des valeurs bi/bo élevées sans wa ? → L'E/S est mise de côté. Des valeurs wa élevées avec des valeurs bi/bo modérées ? → Latence/verrouillage/E/S à distance.
- 1 h 30 – 2 h – Section « system » : rapport in/cs par rapport à sy. cs très élevé ? → Vérifier la pression de changement de contexte, le parallélisme et le verrouillage.
- 2 h 00 – 3 h 00 – Cerner l'hypothèse et choisir l'outil adapté : iostat pour l'indice d'E/S, mpstat pour les asymétries du noyau, pidstat pour les points chauds des processus. Ce n'est qu'ensuite que l'on procède au réglage et à la mise à l'échelle.
Exemples avancés tirés de la pratique
- Saturation du processeur sans r élevé: us+sy à 90%+, id ≈ 0, mais r modéré → point chaud mono-thread ou problème d'affinité. Solution : paralléliser le chemin chaud, vérifier le « core-pinning ».
- Swap-Thrash: dans tous les cas, les valeurs sont nettement supérieures à 0, b/wa augmentent, us diminue → mémoire vive (RAM) nettement insuffisante ou taille du tas (heap) mal dimensionnée. Mesures à prendre : augmenter la mémoire vive (RAM), réduire le jeu de travail, ajuster le paramètre « swappiness ».
- Surcoût du noyau: sy élevé, cs/in élevé, us modéré → nombreux petits appels système/E/S. Solution : traitement par lots, réduction des appels système, vérification des options de montage du système de fichiers.
- Engorgement des réécritures: wa élevé, bo élevé, ondes courtes → limites « dirty » trop élevées, latence de stockage variable. Vérifier le réglage du writeback et le planificateur d'E/S.
- Pression liée à la virtualisation: st visible, r fluctue, id „ saute “ → l'hôte partage le CPU. Solution : vérifier l'attribution/le placement des vCPU, réduire l'overcommit.
Connaître les limites de vmstat
Vmstat est un excellent Capteur d'alerte précoce, mais pas un microscope. Il me montre qu’il y a un blocage et où il se situe – sans identifier le fichier, la requête ou le thread en cause. C’est pourquoi, après le diagnostic vmstat, j’utilise systématiquement des outils plus approfondis, je vérifie mes hypothèses sous plusieurs angles, puis je ne modifie qu’un élément à la fois. Ainsi, les améliorations restent mesurables et reproductibles.
Résumé de la pratique
Grâce à vmstat, je peux déterminer en quelques secondes si le CPU, la RAM, l'espace d'échange ou les E/S constituent un goulot d'étranglement, en analysant conjointement les valeurs de r, b, si/so, bi/bo et us/sy/id/wa/st lire. J'analyse les tendances plutôt que les valeurs individuelles, je compare avec les valeurs de référence et, si nécessaire, je consulte iostat, mpstat, pidstat ainsi que les mesures historiques. En cas de dysfonctionnements aigus, j'ignore la première ligne et je me concentre sur les lignes suivantes, qui présentent un taux d'échantillonnage fixe. Je prends mes décisions en m'appuyant sur les données : r par rapport aux cœurs, si/so durablement différents de 0, wa en hausse persistante, us+sy proches de la pleine charge. Je peux ainsi rapidement définir des mesures concrètes et maintenir les systèmes de manière perceptible réactif.


