 Passer au contenu

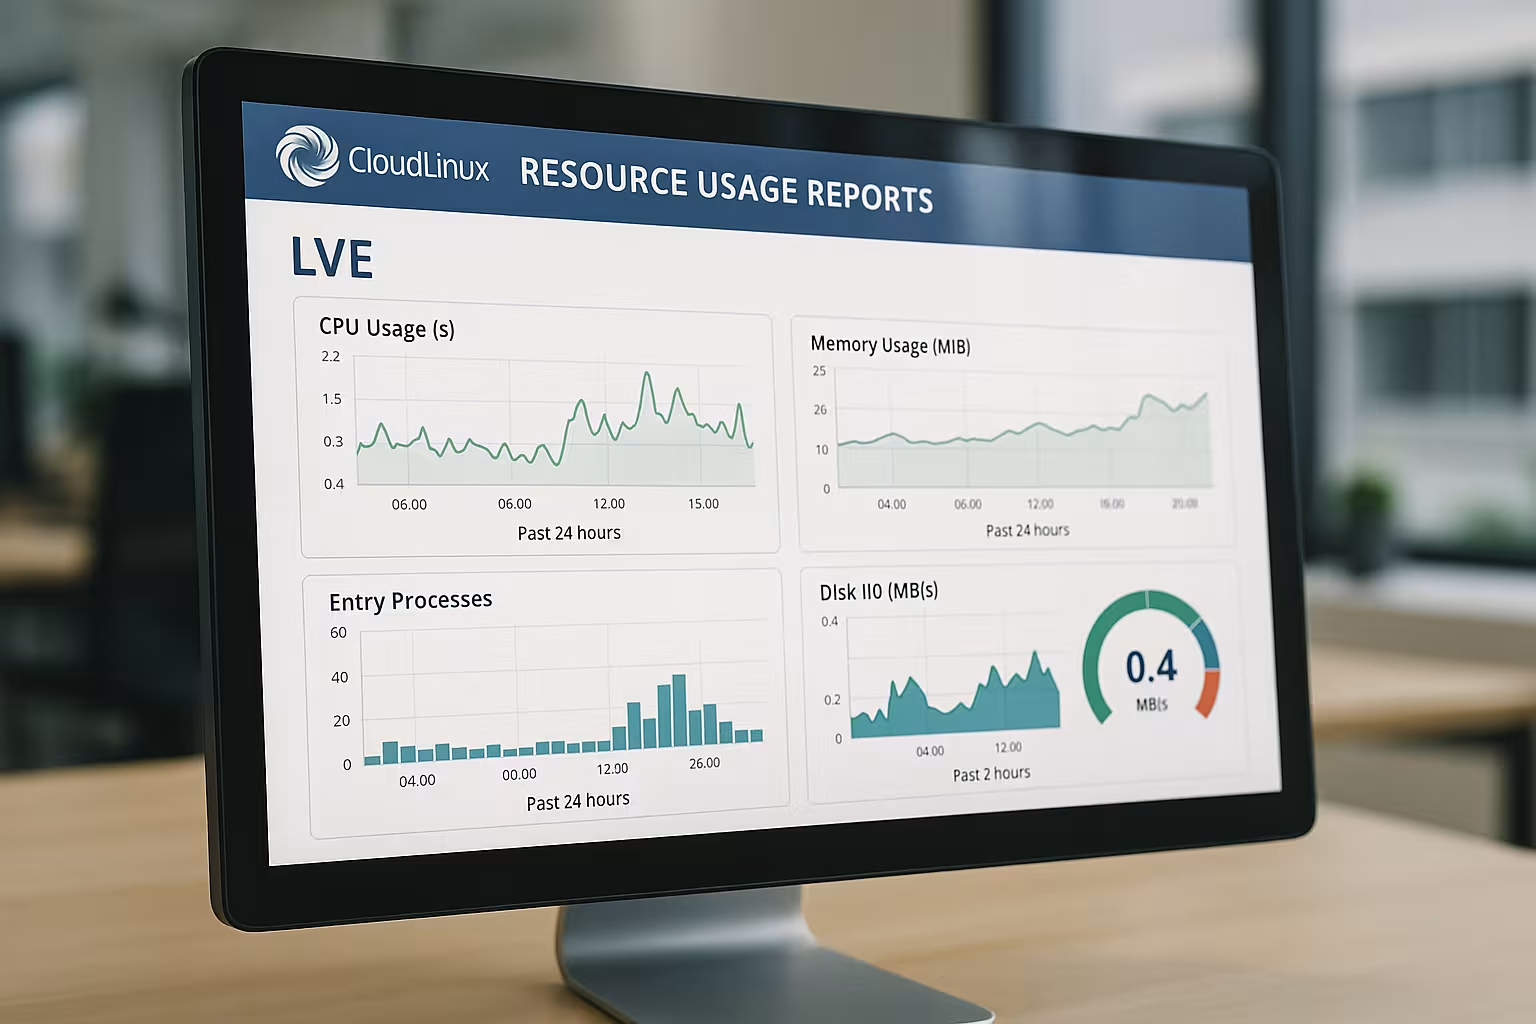
Rapports CloudLinux me montrent clairement quelles limites LVE s'appliquent à chaque compte et où le processeur, la mémoire, les E/S ou les processus d'entrée constituent réellement des freins. J'analyse ces données de manière ciblée afin d'identifier les erreurs récurrentes, les tendances quotidiennes et les goulots d'étranglement aigus, et d'en déduire des optimisations concrètes.
Points centraux
Je résume ci-dessous les points clés afin que tu puisses te lancer dans l'analyse de manière ciblée.
- Indicateurs clés LVE À lire correctement : SPEED, MEM, IO, IOPS, PNO, EP
- Données en temps réel Vérifier avec LVE Manager et lvetop
- Historique via lveinfo, lvechart, cloudlinux-statistics
- Erreurs hiérarchiser : fréquence, moment, cause
- Mesures déduire pour le processeur, la mémoire vive, les E/S et l'EP
Comprendre les indicateurs clés : SPEED, MEM, IO, IOPS, PNO, EP
Je commence chaque analyse par les Chiffres clés, que CloudLinux affiche dans le contexte LVE. SPEED décrit la puissance de calcul CPU allouée, MEM correspond à la consommation de RAM, IO au débit de données et IOPS au nombre d’opérations d’E/S. PNO indique le nombre total de processus en cours d’exécution, EP le nombre de processus d’entrée simultanés qui limitent les accès Web. Si vous constatez des valeurs élevées en permanence, il ne s’agit généralement pas d’un simple pic de charge, mais d’un profil de charge structurel. Je vérifie toujours si les limites sont atteintes en continu ou s’il s’agit uniquement de pics isolés pouvant s’expliquer sans limitation.
| Chiffre clé | Signification | Symptômes typiques | Premières vérifications |
|---|---|---|---|
| SPEED | Performances du processeur (pourcentage/limite) | Durées d'exécution PHP longues, délais d'expiration | Vérifier les profils PHP, le cache d'opcode et la mise en cache |
| MEM | Mémoire vive par compte | OOM-Kills, erreur 500 sous charge | Vérifier la limite de mémoire PHP (memory_limit), les plugins et les requêtes |
| IO | Débit en Mo/s | Téléchargements/envois lents | Cache statique, compression des médias, stockage |
| IOPS | Nombre d'opérations d'E/S | Accès lents à la base de données/aux fichiers | Index, plan de requête, cache d'objets |
| PNO | Processus globaux | Augmentation de la charge du serveur | Excédents de daemons/cron, limites des workers |
| EP | Connexions simultanées sur le Web | Erreur 503 dans Peaks | Vérifier le cache HTTP, les limites de débit et les bots |
Surveillance en temps réel avec LVE Manager et lvetop
Pour les analyses ponctuelles, j'utilise la Données en temps réel dans LVE Manager et lvetop sur le shell. La vue « Current Usage » m’indique en temps réel l’état du CPU, de la RAM, des E/S, des IOPS, des processus et des processus d’entrée. En cas de pics de charge, j’observe si ce sont les EP ou les SPEED qui atteignent en premier leurs limites, car cela influence les étapes suivantes. lvetop permet de filtrer immédiatement les comptes les plus gourmands et, le cas échéant, de les limiter ou de les optimiser. Ceux qui souhaitent approfondir l’utilisation de l’interface peuvent ajuster les limites et les vues de manière ciblée – j’utilise volontiers ce guide à cet effet : Configurer LVE Manager.
Analyse historique : lveinfo, lvechart et cloudlinux-statistics
Je repère les tendances grâce à Historique et l'historique des erreurs, et pas seulement des instantanés. Avec lveinfo, je définis des plages horaires et je vois à quel moment précis les limites ont été déclenchées et à quelle fréquence cela s'est produit. lvechart me fournit des pics visuels sur plusieurs heures ou plusieurs jours, ce qui permet de mettre en évidence les tendances horaires. cloudlinux-statistics complète l’analyse lorsque j’ai besoin de séries chronologiques plus longues par compte. Cette combinaison me permet d’obtenir des réponses aux questions „ quand “, „ à quelle fréquence “ et „ dans quelles conditions “ les pics de charge surviennent.
Comprendre et hiérarchiser les défauts
Une faute signifie : Le Limite a été détectée, et CloudLinux a limité la bande passante. Je trie donc les erreurs d'abord par fréquence, puis par type de ressource et par heure de la journée. Les erreurs EP quotidiennes survenant à midi indiquent souvent des pics de trafic ou la présence de bots, tandis que les erreurs RAM nocturnes sont plutôt liées aux tâches cron et aux sauvegardes. Si les erreurs CPU se multiplient, je recherche des routines PHP inefficaces, des caches défectueux ou des tâches non limitées. Ce classement me fait gagner du temps, car je peux ainsi concentrer mes optimisations précisément là où les utilisateurs subissent des ralentissements perceptibles.
Identifier les causes : schémas typiques et mesures correctives
D'après mon expérience, je classe Échantillon identifie rapidement les causes concrètes. Des valeurs EP élevées et persistantes indiquent un nombre trop important de requêtes simultanées ou l'absence de mise en cache en périphérie. Une consommation de RAM élevée et persistante est souvent le signe de plugins, de thèmes ou de processus présentant des fuites de mémoire. Les pics d'E/S et d'IOPS indiquent des tâches gourmandes en données, des requêtes non indexées ou de nombreux accès à de petits fichiers. Pour éviter toute interprétation erronée, je vérifie en parallèle les indicateurs de santé du système – on peut s'y mettre rapidement grâce aux Contrôles de santé CloudLinux.
Identifier les tâches cron, les sauvegardes et les bots
Pour comprendre bon nombre de séries « Fault », il suffit de jeter un œil à Points de temps et tâches. Si le ralentissement survient toujours peu après l'heure pleine, cela signifie souvent que des tâches Cron s'exécutent en parallèle et entrent en concurrence avec les visiteurs. Les pics récurrents pendant la nuit indiquent souvent des sauvegardes qui saturent les E/S et les IOPS. Des EP-Faults inhabituels sans trafic correspondant dans Analytics indiquent souvent la présence de bots ou de scrapers qui contournent les contenus statiques. Dans de tels cas, je mets en place des limites de débit, je déplace les tâches vers des plages horaires plus calmes et j’active systématiquement les caches en périphérie ou les caches de page.
Analyser les données par revendeur et par compte
Dans les configurations plus importantes, je sépare les Niveaux clarté : les revendeurs, leurs clients et les comptes individuels. Le LVE Manager offre précisément cette vue d'ensemble et m'indique quelle sous-structure est à l'origine des dépassements de limites. Je peux ainsi déterminer si un client en particulier présente des anomalies ou si plusieurs projets d'une même structure de revendeurs exercent simultanément une pression. Pour les processus d’assistance, je sélectionne les comptes concernés et j’enregistre les mesures à prendre afin que les tickets récurrents soient résolus plus rapidement. Cette transparence aide à répartir équitablement les ressources et à garantir la traçabilité des coûts par client.
Dimensionner correctement les seuils et adapter les tarifs
Je fixe des limites réaliste, et non au maximum. Des limites EP trop strictes génèrent des erreurs 503, tandis que des valeurs SPEED trop faibles ralentissent chaque réponse PHP. Si vous constatez régulièrement des erreurs, vérifiez d’abord les optimisations, puis les forfaits. Lorsque les projets deviennent critiques pour l’activité, il vaut mieux opter pour un profil plus élevé, qui atténue les pics et assure une stabilité. Je documente les effets dans les graphiques d’évolution afin que la décision reste compréhensible.
Projets axés sur les bases de données : optimisation des E/S et des IOPS
Pour les sites basés sur une base de données, je vérifie IOPS et les opérations d'E/S sont toujours liées à la qualité des requêtes. De nombreuses petites requêtes sans index génèrent un nombre élevé d'IOPS et ralentissent le temps de réponse. L'expérience montre que le cache d'objets, la mise en cache des requêtes et les index adaptés réduisent considérablement ce flux. Pour les analyses de tendances, je consulte également les rapports de la base de données et je les compare aux évolutions des LVE. Ce guide sur Rapports du gouverneur MySQL, afin de bien classer la charge de la base de données.
Guide de surveillance : de l'alerte à l'action
À partir des valeurs mesurées, je calcule un Guide tactique, qui illustre clairement chaque escalade. Étape 1 : vérifier en temps réel si les limites sont actuellement appliquées et quelle ressource est la première à atteindre ses limites. Étape 2 : ouvrir l'historique, comparer les plages horaires et marquer les répétitions. Étape 3 : Localiser la cause – chemin d'exécution, cache, base de données, Cron, bot – et définir une contre-mesure accompagnée de critères de test. Étape 4 : après l'intervention, vérifier à nouveau en production et dans l'historique si les erreurs et la latence diminuent. Cet ordre fixe évite les mesures précipitées et garantit des résultats reproductibles.
Bien interpréter les interdépendances entre les limites
Dans la pratique, les limites s'appliquent rarement de manière isolée. C'est pourquoi j'évalue les Interactions entre EP, SPEED, MEM et IO/IOPS : si EP et SPEED augmentent simultanément, c'est généralement le CPU qui constitue le goulot d'étranglement par requête ; si un cache de page ou de bord permet d'améliorer la situation, ces deux indicateurs diminuent ensemble. Si j’observe une augmentation de l’EP avec une SPEED constamment faible, cela signifie que les requêtes s’accumulent sur le serveur web, souvent en raison d’un manque de workers, de configurations Keep-Alive ou d’appels externes bloquants (par exemple, API, messagerie). Des erreurs MEM (MEM-Faults) associées à une valeur SPEED modérée indiquent la présence de processus peu nombreux mais gourmands en mémoire (par exemple, conversion d’images, exportations volumineuses). Les pics d’IO/IOPS sans charge CPU notable indiquent des accès à des fichiers ou à des bases de données très gourmands en données. J’utilise ces corrélations pour déterminer la première hypothèse avant d'entrer plus en détail dans les détails du code ou du serveur.
En pratique : utiliser efficacement lvetop, lveinfo et cloudlinux-statistics
Pour obtenir des résultats rapides, je travaille avec des Requêtes et filtrer. lvetop me permet, toutes les secondes, de visualiser les principaux consommateurs et de basculer entre un tri par CPU, MEM ou IO. Avec lveinfo, je définis des fenêtres de 1 h, 24 h et 7 jours pour répertorier les moments des pannes, les valeurs maximales et les ressources concernées par compte. cloudlinux-statistics me fournit des séries chronologiques plus longues et permet de justifier les mesures prises (avant/après). Pour chaque intervention, je documente systématiquement : la période concernée, les comptes affectés, les valeurs maximales par ressource, le nombre de pannes ainsi que les temps de réponse issus de la surveillance des applications ou du Web. Cela me permet de justifier les optimisations et d’éviter que les limites ne soient assouplies „ à l’aveuglette “.
Les subtilités du stack web : gestionnaires PHP, workers et OPcache
Un levier important réside dans la Exécution PHP: le nombre de workers PHP par compte, leur budget de RAM (memory_limit) et l'OPcache. Un nombre trop élevé de workers sans cache augmente les valeurs EP/PNO et MEM, tandis qu'un nombre trop faible engorge les requêtes (l'EP augmente, le temps de réponse s'allonge). Je cherche donc un juste milieu : autant de workers que nécessaire, mais le moins possible. L'OPcache doit être suffisamment dimensionné (mémoire et chaînes internées), sinon PHP recompile sans cesse et fait grimper le SPEED. Par ailleurs, je vérifie si les ressources statiques sont bien servies par le serveur web (et non par PHP) et si le Keep-Alive et le multiplexage HTTP/2 fonctionnent correctement. L'objectif est de traiter les requêtes dynamiques de manière à réduire et de traiter rapidement celles qui restent.
Utiliser systématiquement les stratégies de mise en cache
Je distingue trois niveaux : Cache Edge/CDN pour un allègement global, Cache HTTP/page juste avant PHP et Cache d'objets au sein de l'application. Le cache Edge réduit considérablement l'EP et les E/S pour les ressources statiques. Le cache de page réduit les accès dynamiques et a un impact direct sur l'EP/SPEED. Le cache d'objets (par exemple pour les requêtes fréquentes vers la base de données) réduit les IOPS et la charge CPU. Il est important d'avoir un Clé de cache (par exemple, pas de cookies inutiles) ainsi que des durées de vie (TTL) adaptées à chaque type de page. Je prévois des exceptions pour les zones d'administration ou le panier ; partout ailleurs, je vise un taux de mise en cache aussi élevé que possible. Après l’activation, je vérifie : y a-t-il des erreurs EP ? Les temps de réponse médians diminuent-ils ?
Gestion de la mémoire vive : memory_limit, processus et fuites de mémoire
Les défauts MEM surviennent souvent parce que memory_limit est fixé de manière généreuse et que les processus parallèles font exploser le total. Je procède donc à un calibrage : de combien de RAM une requête type a-t-elle besoin ? À partir de là, je détermine le nombre maximal raisonnable de workers. De plus, je veille à ce que les bibliothèques PHP et les plugins restent légers, je supprime les extensions inutilisées et je vérifie qu’il n’y a pas de fuites dans les scripts à exécution longue (exportations, importations, traitement d’images). L'OPcache réduit la pression sur la RAM en mettant en cache les compilés, mais sa taille ne doit pas être trop réduite. En cas de pics récurrents, j'isole les chemins „ coûteux “ à l'aide du profilage et j'interviens de manière ciblée – cela permet souvent d'économiser davantage de RAM que des augmentations forfaitaires des limites.
Réduire de manière ciblée les opérations d'E/S et les IOPS
Les pics d'IO/IOPS sont dus à de nombreux petits accès aux fichiers ou à la base de données. Je regroupe les charges de travail dans la mesure du possible : génération de vignettes par lots plutôt qu'à la demande, minification des ressources lors de la compilation plutôt qu'à chaque requête, mémoire de session et mémoire temporaire dans un seul Cache d'objets externaliser, afin de réduire le nombre d'accès aux fichiers. Dans la base de données, je donne la priorité aux index pour les clauses WHERE/JOIN fréquentes et j'élimine les requêtes N+1. En parallèle, je compare les historiques LVE avec les rapports de base de données issus de MySQL Governor afin d’identifier les points chauds. L’objectif est de transformer de nombreux petits IOPS en un petit nombre d’accès efficaces, ce qui permet de lisser les pics et de réduire le risque de défaillance.
Atténuer les erreurs EP : mise en file d'attente et flux de visiteurs
EP limite les accès simultanés. Si de nombreuses requêtes se heurtent à des caches vides, les erreurs EP se multiplient rapidement. J'évite cela en Files d'attente avant d'introduire PHP (files d'attente courtes sur le serveur web), je configure le Keep-Alive de manière judicieuse et je veille à ce que les chemins dynamiques non personnalisés soient systématiquement mis en cache. Pour les bots, je définis des limites de débit et je bloque rapidement les « bad actors » évidents. De plus, je vérifie les appels à des services tiers dans le chemin de requête : les services externes qui bloquent les requêtes augmentent le temps de traitement par requête et consomment ainsi de l’EP. Dans la mesure du possible, je déplace les intégrations externes vers des tâches/files d’attente.
Planifier les tâches cron et les sauvegardes en préservant les ressources
Je dissocie les tâches récurrentes des heures de pointe et je les régule : j'étale les tables Cron (en décalant les minutes), j'empêche les exécutions parallèles à l'aide de fichiers de verrouillage, et je régule la charge via Nicing et la taille des lots. Je planifie les sauvegardes pendant les plages horaires où le trafic est faible et je privilégie les méthodes incrémentielles afin que les valeurs IO/IOPS restent dans des limites raisonnables. Pour les tâches complexes exécutées au sein de l'application, je fixe des limites au nombre de workers simultanés afin d'éviter que les valeurs MEM et SPEED n'augmentent de manière brutale. Je vérifie les effets au fur et à mesure : le nombre de failles nocturnes diminue-t-il ? Les pics de charge s'atténuent-ils à l'heure pile ?
CageFS : aperçu du système de fichiers et des inodes
Outre les limites LVE, les facteurs suivants ont une influence Facteurs liés au système de fichiers Les performances : des millions de petits fichiers (tels que des fragments de cache) augmentent les accès aux métadonnées et font grimper les IOPS. Je veille à ce que les répertoires de cache restent bien rangés, je limite le flux de fichiers grâce à des caches regroupés de manière judicieuse et je vérifie l'utilisation des inodes. CageFS assure l’isolation, mais des fichiers temporaires mal placés (par exemple dans le répertoire racine du site Web au lieu du répertoire tmp) augmentent inutilement les E/S. Un contrôle périodique de l'état de ces zones permet d'éviter que les goulots d'étranglement d'E/S ne soient interprétés à tort comme de simples problèmes de CPU ou de RAM.
Transparence et communication dans le contexte de la revente
Dans les environnements de revendeurs, je documente Pilote de charge pour chaque sous-service et consigne les mesures prises : quelles limites ont été fixées ? Quelles optimisations sont prévues ? À quoi ressemblent les graphiques « avant/après » ? Cette transparence accélère les réponses du support et facilite l'acceptation d'un changement de forfait lorsque le potentiel d'optimisation est épuisé. Je définis des seuils à partir desquels nous intervenons (par exemple, pannes récurrentes > N/jour ou temps de réponse médian > X ms), et je les associe à des procédures d’intervention claires – cela permet d’éviter les boucles sans fin dans le système de tickets.
Éviter les interprétations erronées courantes
Je constate régulièrement certains phénomènes : une augmentation de l'utilisation du processeur est pas un message d'erreur indiquant automatiquement „ ressources CPU insuffisantes “ – souvent, les caches ne fonctionnent pas ou les requêtes sont inefficaces. Un nombre élevé d’erreurs EP ne signifie pas nécessairement „ plus de trafic “ : des bots, des outils de surveillance mal configurés ou des heartbeats peuvent en être la cause. Les erreurs MEM ne peuvent pas toujours être résolues en augmentant la valeur de `memory_limit` : souvent, cela est dû à un trop grand nombre de processus simultanés. Les pics d’IO/IOPS ne dépendent pas exclusivement du stockage : ce sont les modèles d’application qui les déclenchent. Je vérifie donc toujours mes hypothèses à l’aide de graphiques corrélés et, si possible, de brefs tests de validation (par exemple, activer le cache pour une partie du système et réexaminer l’historique).
Tester, mesurer, affûter
J'évalue chaque modification avec des points de mesure clairs: avant/après l'activation du cache de pages, avant/après la mise à jour de l'index, avant/après l'ajustement du nombre de workers. Pour cela, j’utilise l’historique LVE, les métriques de temps de réponse et les taux d’erreur (5xx/4xx). Dans la mesure du possible, je réalise des comparaisons A/B aux heures creuses afin d’isoler les répercussions. Si des défaillances persistent, je procède par itérations : ajustement fin des combinaisons de limites, profilage d’autres chemins critiques, adaptation de la taille des lots des tâches. L’expérience le montre : deux à trois itérations ciblées donnent des résultats nettement meilleurs qu’une seule mesure globale.
Résumé : Comment consulter efficacement les rapports d'utilisation des ressources de CloudLinux
Je note CloudLinux- Les données sont toujours classées en trois niveaux : en temps réel, historique, erreurs. Les indicateurs SPEED, MEM, IO, IOPS, PNO et EP me fournissent une vue d'ensemble des causes et des effets. Avec lvetop, je vois immédiatement qui sollicite le système ; grâce à lveinfo et lvechart, je mets en évidence les tendances sur plusieurs jours. À partir des Faults récurrents, je déduis les besoins en matière de mise en cache, d’optimisation des requêtes, d’ajustement des limites ou de changement de forfait. Cette méthode réduit la charge de travail du support, améliore la réactivité et rend les performances d’hébergement transparentes.


